요약:
애플 연구팀이 로봇 '뇌' 연구의 진전 상황을 공개합니다. 현지 시간으로 11월 4일, Apple 연구팀은 사전 인쇄 플랫폼 arXiv에 "시뮬레이션에서 얻은 지각 휴머노이드 모션(Perceptive Humanoid Motion from Simulation)"이라는 논문을 제출하고 휴머노이드 로봇 자율 제어 시스템 HALO를 공개했습니다. 연구팀은 검증을 위해 Yushu Technology의 G1 휴머노이드 로봇에 시스템을 배포하여 로봇이 시뮬레이션 환경에서 학습한 동작을 수행하고 익숙하지 않은 실제 방에서 수행할 수 있도록 했습니다.
또한 연구팀은 액션 생성, 액션 추적, 작업 조정, 시뮬레이션 및 실제 로봇 작동을 다루는 데이터 생성, 모델 훈련 및 배포 코드를 공개했습니다.
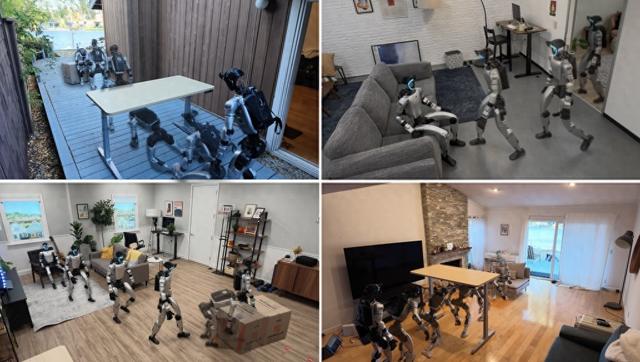
The Yushu G1 HALO 시스템을 탑재한 로봇은 다양한 실제 환경에서 테이블 밑으로 기어가기, 소파에 앉기, 상자 밀기 등의 작업을 시연합니다. 이미지 출처: HALO 연구팀
프로젝트 페이지에서는 로봇이 상자 밀기, 사람 따르기, 의자에 앉기, 반쯤 열린 문 통과하기, 테이블 아래로 몸을 구부리기 또는 기어가기 등의 지시를 따르는 것을 보여줍니다. 이러한 작업을 수행하려면 로봇이 주변 환경을 이해하고 공간 조건에 따라 신체 자세를 조정해야 합니다.
작업을 실행할 때 HALO는 세 가지 수준으로 공동으로 제어됩니다. 최상위 계층은 VLM(Visual Language Model)을 기반으로 하는 작업 조정 모듈입니다. 기본적으로 Qianwen Qwen3.6-35B-A3B를 사용합니다. 로봇에 장착된 Mac mini에서 로컬로 실행됩니다. 이는 액션 생성기와 모델 서비스 엔진을 공유하며 인터넷 연결 없이도 작동할 수 있습니다. 또한 시스템은 더 강력한 추론 및 계획 기능을 얻기 위해 API를 통해 클라우드 모델을 호출하도록 선택할 수도 있습니다.
이 레이어는 명령어의 퍼지 정보를 처리하고 환경에 따라 작업을 정렬해야 합니다. 예를 들어, "앉아"에는 명확하게 지정된 목표가 없으며 로봇이 앞 장면에서 앉을 위치를 결정해야 합니다. '의자에 앉기'는 길이 비어 있을 때 바로 실행할 수 있지만, 길을 막고 있는 탁자가 있다면 몸을 숙이고, 의자에 다가가고, 앉는 등 연속적인 하위 작업으로 나누어야 한다. 작업 조정 모듈은 로봇의 관점에서 영상을 통해 환경을 지속적으로 관찰하고, 현재 작업이 성공했는지 판단하고, 그에 따라 계획을 진행하거나 재시도하여 매번 작업 생성기에 명확한 하위 작업을 발행합니다.
중간 액션 생성 레이어는 또 다른 Qianwen 모델 Qwen3.5-2B를 사용합니다. 연구팀은 이를 매개변수 동결 인코더로 활용하고 동작 생성을 담당하는 DiT 디코더와 협력해 로봇이 본 사진과 현재 하위 작업을 기반으로 향후 약 5초 동안 전신 움직임을 계획한다. 이 레이어는 초당 약 3번씩 재계획되므로 환경 변화에 따라 실행 계획이 지속적으로 업데이트될 수 있습니다.
하단 레이어는 강화 학습, 정책 증류 및 기타 단계를 통해 훈련된 액션 추적기입니다. 초당 50번의 빈도로 실행되며 깊이 이미지와 로봇 자체 상태를 결합하고 행동 계획을 공동 제어 명령으로 변환합니다.
세 가지 수준은 각각 작업 배치, 작업 계획 및 신체 제어를 담당하며 지침 이해부터 작업 실행까지 프로세스를 공동으로 완료합니다.
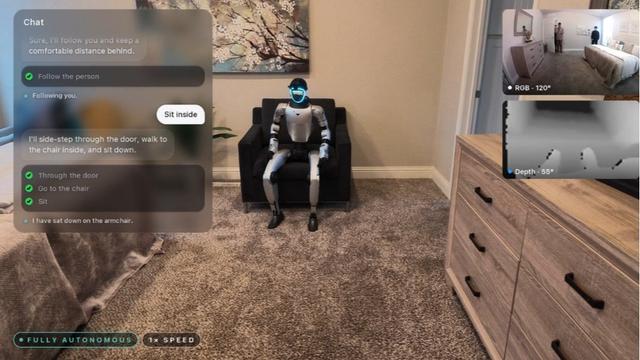
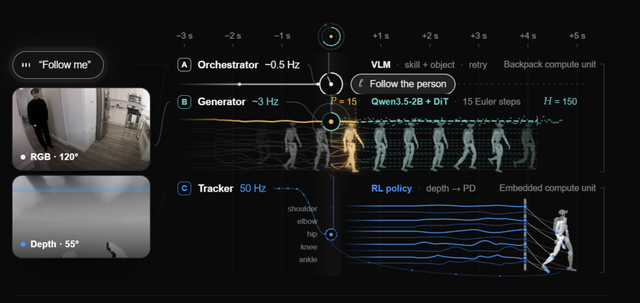
HALO의 3계층 제어 아키텍처: 시각적 언어 모델은 작업 조정을 담당하고, 생성 모듈은 전신 움직임을 계획하며, 강화 학습으로 훈련된 동작 추적기는 공동 제어를 수행합니다. 이미지 출처: HALO 프로젝트 페이지 스크린샷 모자이크
논문에 따르면 연구팀은 사전 스캔이나 매핑 없이 6개의 실제 환경에서 360개의 단일 작업 테스트를 수행했으며 평균 성공률은 91%였습니다. 또 다른 실제 환경에서는 3가지 결합 작업에 대해 10번의 테스트를 실시했으며 평균 성공률은 70%였다. 그 중 '장애물에 기대기 - 목표를 향해 걷기 - 상자 밀기' 조합의 성공률은 50%다.
로봇이 이러한 작업을 완료하는 데 필요한 데이터를 얻는 방법이 이 연구의 초점입니다. 연구팀은 '로봇이 무엇을 보았는지', '어떤 지시를 받았는지', '어떻게 움직이는지'를 일치시키기 위해 프로그램으로 생성된 1,000개의 시뮬레이션된 가정 환경에서 약 300시간의 기본 훈련 데이터를 합성했습니다.
구체적으로 시스템은 먼저 액션을 생성한 다음 액션을 가상 공간에 배치하고 마지막으로 로봇의 관점에서 이미지를 생성합니다. 프로젝트 페이지는 '안락의자에 앉다'를 예로 들어 앞으로 걷기, 돌아서기, 앉기 등의 세그먼트로 나눕니다. 액션 생성 모델은 텍스트 프롬프트, 웨이포인트, 주요 자세를 기반으로 액션 시퀀스를 생성합니다. 그런 다음 발이 미끄러지거나 바닥에 신체가 침투하는 등의 문제를 줄이기 위해 기하학적 검사를 통해 동작을 검사합니다.
그런 다음 시스템은 프로그램이 생성한 방에 작업을 배열하고, 로봇과 가구 사이의 위치 관계를 확인하고, 충돌 없는 배치 계획을 찾은 다음, 시뮬레이션 도구를 사용하여 로봇이 작업을 수행할 때 보는 것을 렌더링합니다. 훈련 중에는 조명, 색조, 이미지 흐림 등의 조건도 변경되어 시각적 입력이 더욱 다양해집니다. 이러한 방식으로 동일한 프로세스를 통해 지침, 시각적 이미지, 전신 동작을 포함한 지원 데이터를 생성할 수 있습니다.
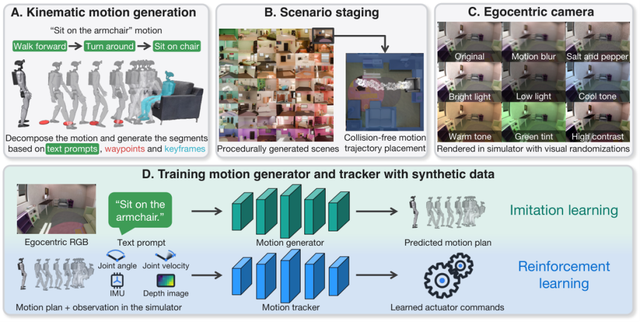
HALO의 합성 데이터 생성 및 훈련 프로세스: 먼저 액션 궤적을 생성하고 이를 가상 장면에 넣은 다음 로봇의 관점에서 이미지를 렌더링하여 액션 생성기와 액션 추적기 훈련을 위한 지원 훈련 데이터를 형성합니다. 이미지 출처: HALO 종이
보고서에 따르면 연구팀은 250개의 NVIDIA H100 GPU를 사용했으며 주요 훈련 데이터를 합성하는 데 약 48시간이 걸렸습니다. 동작 생성기는 64개의 B200을 사용하여 모방 학습을 통해 훈련됩니다. 행동 추적기는 4개의 H100을 사용하여 강화 학습, 정책 증류 및 기타 단계를 통해 훈련됩니다.
시뮬레이션으로 생성된 데이터가 인간의 참여를 완전히 없애지는 못한다는 점을 지적해야 합니다. 팀은 새로운 물리적 작업에는 여전히 프롬프트 단어를 수동으로 작성하고 동작 키 프레임을 디자인해야 하며 일부 동작에는 휴먼 비디오 또는 모션 캡처 자료를 사용한다고 밝혔습니다.
또한 연구팀은 현재 로봇은 주로 시각적 인식에 의존하며 접촉 상황을 직접적으로 인식하기 어렵다고 지적했습니다. 물체가 카메라 시야를 벗어나거나 가려지면 더 많은 접촉이 필요한 작업의 성능이 저하됩니다. 촉각 인식을 추가하는 것은 후속 개선 방향 중 하나입니다.
댓글