요약:
DeepSeek도 매개변수 경쟁에 참여했습니다. The Information에 따르면 DeepSeek은 현재 약 2조 개의 매개변수를 사용하여 새로운 모델을 훈련하고 있습니다. Liang Wenfeng은 또한 최근 투자자 회의에서 회사의 다음 단계는 모델을 8조 매개변수로 계속 추진하는 것이라고 밝혔습니다. 1년 전만 해도 8조는 여전히 상상할 수 없는 숫자였습니다.
그러나 이제 Kimi K3는 2조 8천억 개의 매개변수에 도달했습니다. Byte는 최대 10조 개의 매개변수에 도달할 수 있는 새로운 모델을 사전 훈련하고 있습니다. 알리바바는 또한 차세대 모델이 5조~10조 개의 매개변수를 향해 추진할 것이라고 공개적으로 밝혔습니다. Anthropic은 모델 매개변수를 공개하지 않지만, FT는 이전에 최신 주력 제품인 Mythos 5에 약 8조 개의 매개변수가 있다고 업계 추정치를 인용한 바 있습니다.
큰 모델은 원을 그리며 돌아다니며 누가 더 큰지 다시 경쟁하기 시작했습니다.
이번만 모든 사람이 롤아웃하는 매개변수는 더 이상 이전 확장 조정 라운드와 동일한 매개변수가 아닙니다.
올해 4월 DeepSeek이 V4-Pro를 출시했을 때 공식적으로 공개된 규모는 총 매개변수 1조 6천억 개, 활성화 매개변수 490억 개였습니다.
후속 계획은 8조 위안으로 V4-Pro의 5배에 해당한다.
DeepSeek의 경우 이는 실제로 매우 이례적인 일입니다. 결국 딥식은 지난해 AI 업계 전체에 매개변수 측면이 아닌 가장 깊은 인상을 남겼다.
이로 인해 AI 업계는 최첨단 모델이 GPU를 무한정 소모할 필요가 없을 수도 있다는 점을 다시 논의하게 되었습니다.
2024년 말 V3가 출시되면 DeepSeek은 의도적으로 훈련 비용을 테이블에 올려 놓습니다. 총 매개변수는 6,710억 개, 토큰당 활성화된 매개변수는 370억 개, 전체 훈련은 H800 GPU 시간 278만8000시간을 소비합니다. GPU 시간당 2달러로 계산하면 공식 학습 비용은 557만 6천 달러에 불과합니다.
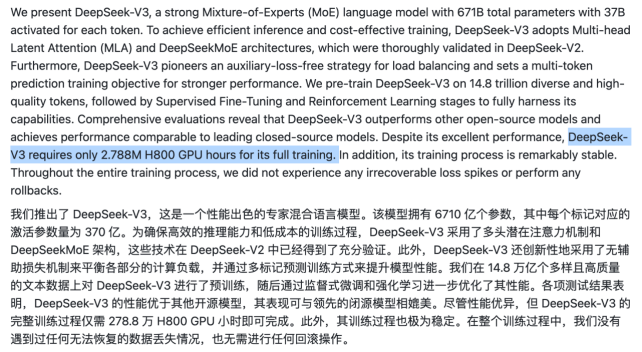
이 숫자와 그 뒤에 숨은 효율성은 나중에 DeepSeek의 가장 중요한 레이블 중 하나가 되었습니다.
DeepSeek에는 OpenAI 및 Anthropic과 같은 고급 GPU가 풍부하지 않습니다. 회사는 오랫동안 Liang Wenfeng의 Huanfang에 의존하여 자가 수혈을 정량화해 왔으며 외부 자금 조달을 받아들이지 않습니다. 조건에 따라 경로가 결정됩니다. 돈과 컴퓨팅 성능이 제한되어 있으므로 아키텍처, 교육 및 추론 효율성을 통해 성능이 극대화되어야 합니다.
그러나 이제는 조건이 바뀌었습니다.
DeepSeek은 올해 6월 설립 이후 첫 번째 외부 자금 조달을 완료하여 약 74억 달러의 자금을 조달했습니다. 현재 약 500억 위안(약 75억 달러)에 달하는 2차 자금조달이 마무리 단계에 진입했으며, 이는 약 5000억 위안의 평가액에 해당합니다. 이번 자금 조달이 성공적으로 완료되면 DeepSeek의 누적 외부 자금 조달 규모는 몇 달 내에 미화 150억 달러, 약 1000억 위안에 달하게 됩니다.
동시에 DeepSeek는 과학기술혁신위원회의 IPO를 준비하기 위해 CITIC Securities를 고용했으며, 새로운 자본은 컴퓨팅 인프라, 모델 개발 및 인재 투자에 명확하게 사용될 것입니다. 9월 21일, 전 Hillhouse Venture Partners 파트너였던 Yan Wentao가 DeepSeek에 공식 합류하여 CFO로 재직하면서 회사 설립 3년 만에 CFO 공석이 해소되었습니다.
과거에는 DeepSeek가 제한된 자금과 컴퓨팅 능력을 사용하여 가능한 한 좋은 모델을 만들었습니다. 현재 자금 조달 및 상장이 추진되고 있습니다. 더 많은 돈을 확보하면 컴퓨팅 성능도 향상될 수 있습니다.
조건이 충족되면 DeepSeek도 과감하게 매개변수를 출시하기 시작합니다.
이는 효율성 추구와 충돌하지 않습니다. 효율성이 높으면 같은 돈으로 규모를 확장할 수 있다.
지난 두 달 동안 최첨단 모델의 전체 매개변수 규모가 크게 증가했습니다.
이 경쟁을 다시 주목받는 것은 The Dark Side of the Moon입니다. 올해 7월 키미K3는 총 매개변수 2조8000억개, 활성화 매개변수 1040억개를 달성했다. K3는 여전히 공식적으로 출시된 파라미터 스케일 중 가장 큰 오픈 웨이트 모델입니다.
그냥 큰 게 아닙니다. 공식 평가에서는 K3의 GPQA 다이아몬드가 93.5, 터미널-벤치 2.1이 88.3을 기록해 같은 기간 GPT-5.6 솔, 클로드 페이블 5와 매우 근접한 수준이다. 규모는 수조에 이르렀고, 성능은 1계단에 도달했습니다.
지난 8월 바이트는 더 큰 규모로 성장할 계획인 것으로 밝혀졌습니다.
8월 6일, 'LatePost'는 바이트가 Seed Foundation의 Xiang Liang 대표를 중심으로 5조 개 이상의 매개변수를 가진 새로운 모델 훈련을 논의하고 있다는 사실을 처음 공개했습니다. 보고서에 따르면, Byte는 내부적으로 기존 크기를 계속 따라잡는 대신 매개변수 규모를 동종 업체보다 한 번에 몇 배 더 높게 밀어붙이는 것이 더 낫다고 믿는 것 같습니다.
어느 날인 8월 7일, FT는 이 문제에 정통한 사람들의 말을 인용하여 Byte가 사전 훈련하는 새로운 모델의 규모가 최대 10조 개의 매개변수에 도달할 수 있다고 보도했습니다. Reuters는 후속 조치를 취하면서 이를 Anthropic의 최첨단 Mythos와도 비교했습니다. 후자는 매개변수 규모를 공개한 적이 없지만 업계 추정치는 약 8조에 달합니다. Byte의 새로운 모델이 10T에 도달하면 현재 Mythos가 유통하는 규모를 초과하게 됩니다.
이제 최첨단 모델 논의에서는 5T가 넘는 극도로 큰 매개변수량이 반복적으로 등장하기 시작했다.
오늘 Alibaba CEO Wu Yongming은 차세대 모델이 5조~10조 개의 매개변수를 달성할 계획이라고 공개적으로 발표했습니다. DeepSeek은 후속 목표를 8T로 설정하면서 2T 모델을 훈련하고 있습니다. 본 연구소는 다시 한 번 더 큰 전체 매개변수 규모를 능력의 상한선에 영향을 미치는 중요한 경로로 간주했다는 것을 이해할 수 있습니다.
매개변수를 공개하지 않는 미국의 비공개 소스 모델이라도 감시 외부에서 벗어날 수는 없습니다. Anthropic's Mythos는 외부인에 의해 8T로 추정됩니다. OpenAI는 GPT-4 시대 이후 더 이상 모델 규모를 공개하지 않았지만, 커뮤니티에서는 Astra가 10T MoE에 도달했다는 소문이 돌고 있습니다.
매개변수의 수는 게임 패널의 전투력 값과 마찬가지로 그 매력을 잃지 않았습니다. 사람들은 이것이 모든 것을 나타낼 수는 없다는 것을 알고 있지만 항상 가장 직관적이고 억압적인 숫자가 될 것입니다.
사실 대형 모델 업계에서는 한동안 매개변수에 대한 이야기를 별로 좋아하지 않았습니다.
지난 2년 동안 증류, 소형 모델, MoE, 강화 학습, 추론 시간 계산이 차례로 진행되었습니다. 모델 제조업체는 수천억 또는 수조 개의 매개변수를 가지고 있음을 과시하기보다는 성능, 비용 및 효율성에 대해 더 많이 이야기합니다. 단순히 모델을 더 크게 만들면 돈은 있지만 쓸 곳이 없는 것처럼 보이기 쉽습니다.
오늘날 매개변수 수량이 다시 증가하여 다시 한번 최첨단 모델의 '전선'이 되었습니다.
그러나 오늘날의 5T, 8T, 10T는 더 이상 이전 Scaling 라운드의 "매개변수가 많을수록 모델이 커집니다"와 동일한 것이 아닙니다.
매개변수 수량을 다시 테이블에 올릴 수 있는 가장 직접적인 이유는 초대형 모델의 주류 아키텍처가 변경되었기 때문입니다.
과거 대형 모델의 주류는 매개변수 규모와 계산량이 기본적으로 묶여 있는 Dense 아키텍처였습니다. 간단히 말하면, 모델에 몇 개의 매개변수가 있는지를 의미하며 기본적으로 모든 계산에 함께 입력해야 합니다. 매개변수가 많을수록 능력의 상한이 높아지는 경향이 있지만 훈련 및 추론 비용도 증가합니다.
요즘에는 MoE, 전문가 혼합, 혼합 전문가 아키텍처를 사용하는 대형 모델이 점점 더 많아지고 있습니다.
전문가가 많은 회사에 가깝습니다. 모델에는 수백 또는 수천 명의 전문가가 있을 수 있지만 그 중 극히 일부만이 각 작업을 수행하도록 선택됩니다. 예를 들어 Kimi K3에는 총 2.8T 매개변수가 있지만 각 토큰은 약 3.7%인 104B만 활성화합니다. DeepSeek V4-Pro에는 총 1.6T의 매개변수가 있으며 각 토큰은 약 3%인 49B만 활성화합니다.
따라서 오늘날 모델에 5T, 8T 또는 10T 매개변수가 있다고 해서 토큰을 생성할 때마다 이러한 10T 매개변수를 실행해야 한다는 의미는 아닙니다.
모델이 보유할 수 있는 양과 매번 계산해야 하는 양은 서로 다른 두 가지 숫자가 되었습니다.
매개변수는 모델이 지식, 패턴, 기능을 전달하기 위해 사용하는 공간으로 이해될 수 있습니다. 총 매개변수가 클수록 이론적으로 모델이 점점 더 복잡한 분포를 학습해야 하는 공간이 더 커집니다. MoE에서는 필요한 경우에만 그 중 일부를 호출할 수 있도록 허용합니다.
결과적으로 모델은 각 계산을 전년 대비 더 무겁게 만들지 않고도 총 매개변수 용량을 계속해서 늘릴 수 있습니다.
아직 K3를 예로 들자면 총 매개변수가 2.8T로 K2.5의 약 3배 규모지만 전문가 896명 중 각 토큰은 16개만 활성화된다. Dark Side of the Moon은 더 희박한 MoE와 일련의 아키텍처 최적화 덕분에 K3의 전반적인 확장 효율성이 K2에 비해 약 2.5배 향상되었다고 말했습니다.
에이전트 시대는 이 '역량'을 다시 경쟁의 중심으로 밀어 넣었습니다.
과거에는 챗봇의 능력을 하나씩 측정하는 경우가 많았습니다. 수학은 수학을 보고, 코드는 코드를 보고, Q&A는 지식을 봅니다. 모델이 여러 주요 벤치마크에서 더 높은 정점에 도달하면 모델이 매우 강력하다는 것을 입증하기에 충분합니다.
그러나 에이전트는 이러한 기능을 동일한 작업 체인에 연결합니다. 정말 긴 작업은 정보 검색으로 시작하여 웹 페이지를 읽고, 그림을 보고, 코드를 작성하고, 터미널을 호출한 다음 오류가 발생하고, 계획을 수정하고, 다른 도구를 호출하고, 심지어 다른 에이전트에게 하위 작업을 할당할 수도 있습니다.
OpenAI는 올해 9월 에이전트 API를 출시하면서 장기 실행, 컨텍스트 관리, 도구 사용, 하위 에이전트 조정을 에이전트의 핵심 인프라로 직접 나열하고 에이전트가 몇 시간, 심지어 며칠 동안 안정적으로 실행되어야 한다고 강조했습니다.
Q&A에서 가끔 특정 능력이 실패하는 경우 질문 하나만 손실될 수 있습니다. 수십 또는 수백 단계가 포함된 에이전트 작업에서는 약한 링크로 인해 전체 링크가 중단될 수 있습니다. 작업이 길어질수록 기능 적용 범위와 안정성에 대한 요구 사항이 높아집니다. 그 결과, 프런티어 경쟁이 명백한 '배럴 효과'를 나타내기 시작했습니다.
METR은 이제 '작업 시간 범위'를 직접 사용하여 에이전트 기능을 측정하기도 합니다. 작업이 길어질수록 모델이 일련의 다양한 작업을 지속적으로 완료해야 하는 요구 사항이 높아지기 때문입니다.
챗봇 시대에는 역량의 정점을 쉽게 볼 수 있는 반면, Agent 시대에는 역량 범위가 점점 중요해집니다.
이때 매개변수 용량이 커질수록 새로운 가치를 갖게 됩니다. 작업이 길어질수록 모델의 편향이 줄어듭니다. 에이전트가 수행할 수 있는 작업이 많을수록 기반이 처리해야 하는 기능도 더 넓어집니다.
MoE는 지속적인 용량 확장의 여지를 열어주고 Agent는 용량의 가치를 더욱 증폭시킵니다. 따라서 모델 제조사에서는 매개변수를 다시 5T, 8T, 10T로 밀어붙이면서 효율성을 높이기 위해 최선을 다하고 있습니다.
절약된 컴퓨팅 파워로 인해 Scaling이 사라지는 것이 아니라 Scaling을 위한 새로운 공간이 만들어졌습니다.
댓글