요약:
인공지능 스타트업 Architect Labs는 자사의 실험적인 Frostbite CPU 아키텍처가 기존 프로세서 코어보다 와트당 4.59배, 단위 면적당 8.77배 더 높은 성능을 가지고 있다고 주장합니다. 인공 지능을 사용하여 처음부터 설계된 Frostbite는 컴퓨팅에 대해 근본적으로 다른 접근 방식을 취하지만 인상적인 결과는 아직 실제 칩에서 검증되지 않았습니다.
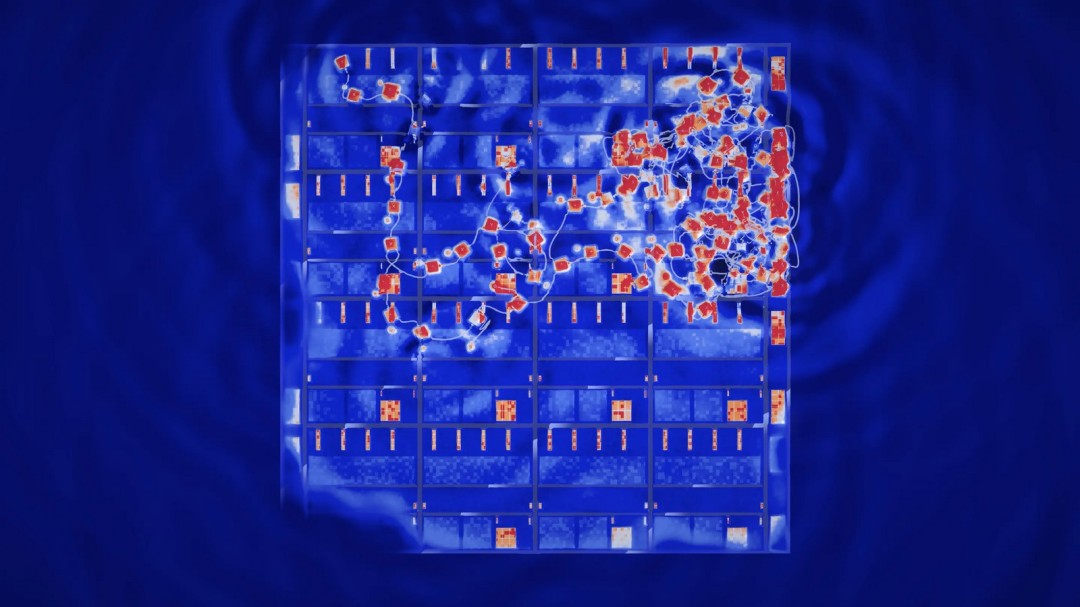
미국의 인공지능 스타트업인 Architect Labs는 자사의 인공지능 시스템이 명령 세트, 마이크로아키텍처, RTL 코드, 검증 및 최종 GDS 레이아웃을 포함하여 처음부터 새로운 범용 CPU 아키텍처를 설계했다고 주장합니다. 회사는 25개 워크로드 미만에서 새로운 디자인의 와트당 성능은 기존 CPU 코어의 4.59배, 단위 면적당 성능은 기존 CPU 코어의 8.77배라고 주장합니다. 그러나 이러한 결과는 실제 물리적 프로세서가 아닌 칩 전 제조 시뮬레이션에서 나온 것입니다.
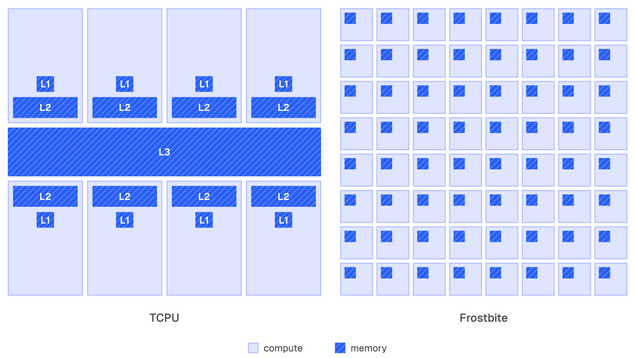
기존 CPU와 달리 Frostbite 아키텍처는 1990년에 처음 제안된 상호작용넷(interactionnets)이라는 수학적 모델을 기반으로 합니다. 단일 대형 코어에 의존하는 대신 상호작용 네트워크 형태로 표현되는 프로그램을 실행하는 작은 컴퓨팅 장치 그리드를 사용합니다. 상호작용 네트워크는 연결된 노드를 로컬에서 다시 작성하여 계산이 수행되는 그래프입니다. 각 컴퓨팅 장치는 자신의 작업을 먼저 처리하고 유휴 상태일 때 인접한 컴퓨팅 장치로부터 추가 작업을 받습니다. 수행할 작업이 없으면 전원을 절약하기 위해 비활성 상태로 전환될 수 있습니다. 이 분산 접근 방식을 사용하면 중앙 집중식 스케줄러가 필요하지 않으며 아키텍처의 확장성을 높이도록 설계되었습니다.
Architect Labs는 이 접근 방식을 통해 공유 가변 메모리, 복잡한 캐시 계층 구조 및 캐시 일관성 메커니즘의 필요성도 줄어든다고 말합니다. 각 값에는 소유자가 한 명뿐이며 계산은 연결된 노드 간의 로컬 상호 작용을 통해 수행됩니다. 프로그램은 Rust와 유사한 구문을 사용하여 회사에서 개발한 Vine 언어로 작성되고 Ivy라는 중간 표현으로 컴파일됩니다.
회사는 AI 시스템이 "아키텍처에 대한 사전 지식 없이" 아키텍처를 탐색하고 컴파일러, 명령 세트, 아키텍처, 마이크로아키텍처, RTL, 검증 및 최종 GDS 레이아웃을 반복했다고 밝혔습니다. 이 프로세스에서는 공식적이고 기계 검증 가능한 사양과 다중 에이전트 클러스터를 사용했으며, 4차례의 검색과 최종 테스트를 통해 총 58개의 제안이 고려되었습니다. Architect Labs는 37개의 제안이 최종적으로 유지되었다고 말했습니다.
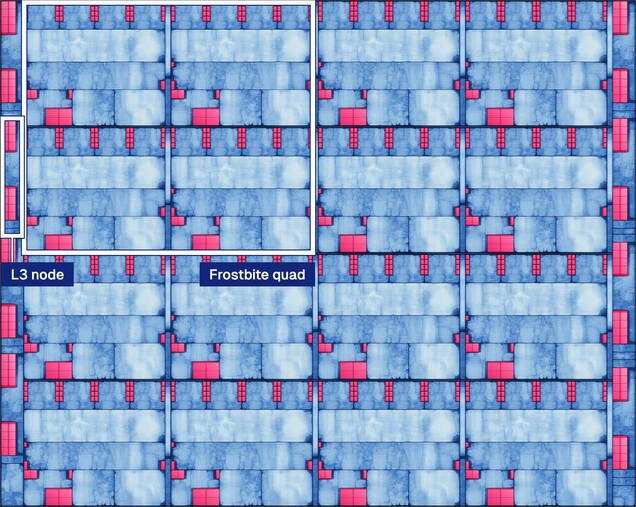
Frostbite의 7nm 레이아웃은 4×4 그리드를 특징으로 하며 2×2 Frostbite 쿼드와 L3 노드를 강조합니다.
성능 평가를 위해 Architect Labs는 7nm 공정을 사용하여 Frostbite 코어를 합성했습니다. 설계는 합성 과정에서 800MHz의 주파수에 도달했고 최종 물리적 레이아웃은 500MHz였습니다. Frostbite Quad는 2×2 그리드로 배열된 컴퓨팅 유닛 4개와 L3 캐시 노드 4개로 구성되며 면적은 0.792제곱밀리미터입니다. 비교용 CPU 코어(회사에서는 TCPU라고 함)는 동일한 공정 기술을 사용하며 면적은 0.895제곱밀리미터입니다. 법적인 이유로 Architect Labs는 경쟁 프로세서의 신원을 공개하지 않습니다.
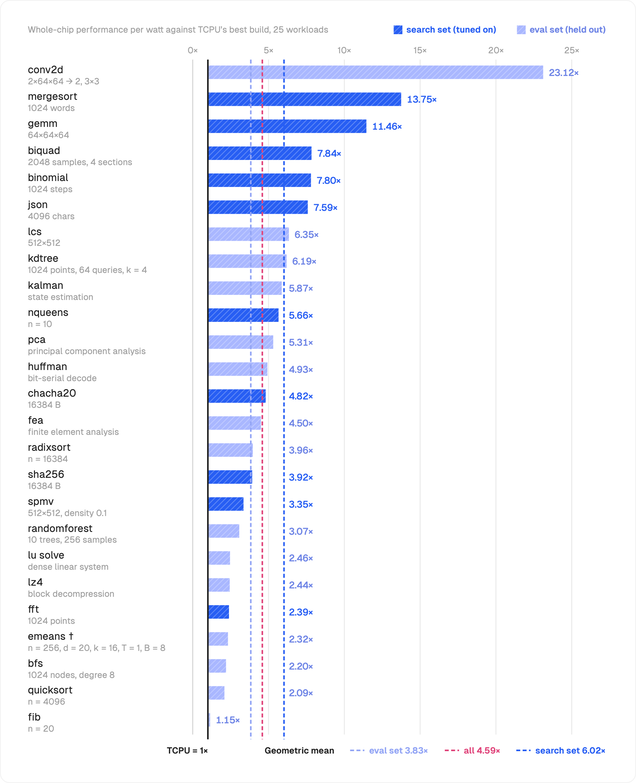
25번의 작업 부하 테스트에서 Frostbite 아키텍처는 참조 CPU 코어보다 4.59배에 달하는 와트당 기하 평균 성능을 달성했습니다. 최적화 프로세스 중에 사용된 10개 워크로드 테스트에서는 이점이 6.02배, 최종 평가 전에 유지된 15개 워크로드 테스트에서는 3.83배에 도달했습니다. 회사는 또한 단위 면적당 최대 8.77배의 성능 이점을 보고했습니다.
25개 워크로드 미만의 기존 CPU와 비교하여 Frostbite 아키텍처의 와트당 성능은 어떻습니까? 점선은 검색 세트, 홀드아웃 세트 및 모든 작업 부하의 기하 평균을 나타냅니다.
Architect Labs는 메모리 트래픽과 명령어 오버헤드 감소로 인해 성능이 향상되었다고 밝혔습니다. 테스트 결과는 작업 부하에 따라 크게 달라집니다. Frostbite는 고도로 병렬화된 작업에서 특히 뛰어난 성능을 발휘하며, Architect Labs는 분기 및 동적 워크로드에서도 레퍼런스 코어보다 성능이 뛰어나다고 지적했습니다. 회사는 업계 표준 SPEC 및 PARSEC 벤치마크를 포함하도록 테스트를 확장하고 이를 더 크고 더 넓으며 순서가 잘못된 CPU 설계와 비교할 계획입니다.
결과는 고무적이지만 Frostbite 아키텍처는 아직 실험 단계에 있으며 대량 생산 프로세서는 아닙니다. Architect Labs는 Frostbite 칩의 대량 생산이나 출시 계획을 발표하지 않았습니다. 회사는 RTL 및 명령어 세트 아키텍처(ISA)를 출시하고, FPGA 기반 소프트웨어 테스트 플랫폼을 구축하고, 예비 운영 체제를 개발하고, SPEC 및 PARSEC와 같은 업계 표준 벤치마킹 도구를 사용하여 대규모 Frostbite 구성의 성능을 멀티 코어 CPU와 비교할 계획입니다.
댓글