요약:
Google DeepMind 엔지니어는 최근 창의적인 실험을 시연했습니다. 그는 Google의 Gemma 3 270M 소형 언어 모델을 일반 사무용 레이저 프린터에서 직접 실행하는 데 성공했습니다. 이 모델의 매개변수 수는 약 2억 7천만 개이며, 실험에 사용된 프린터는 사용 가능한 메모리가 14.1MB에 불과하지만 여전히 초당 60단어 이상의 생성 속도를 달성합니다.
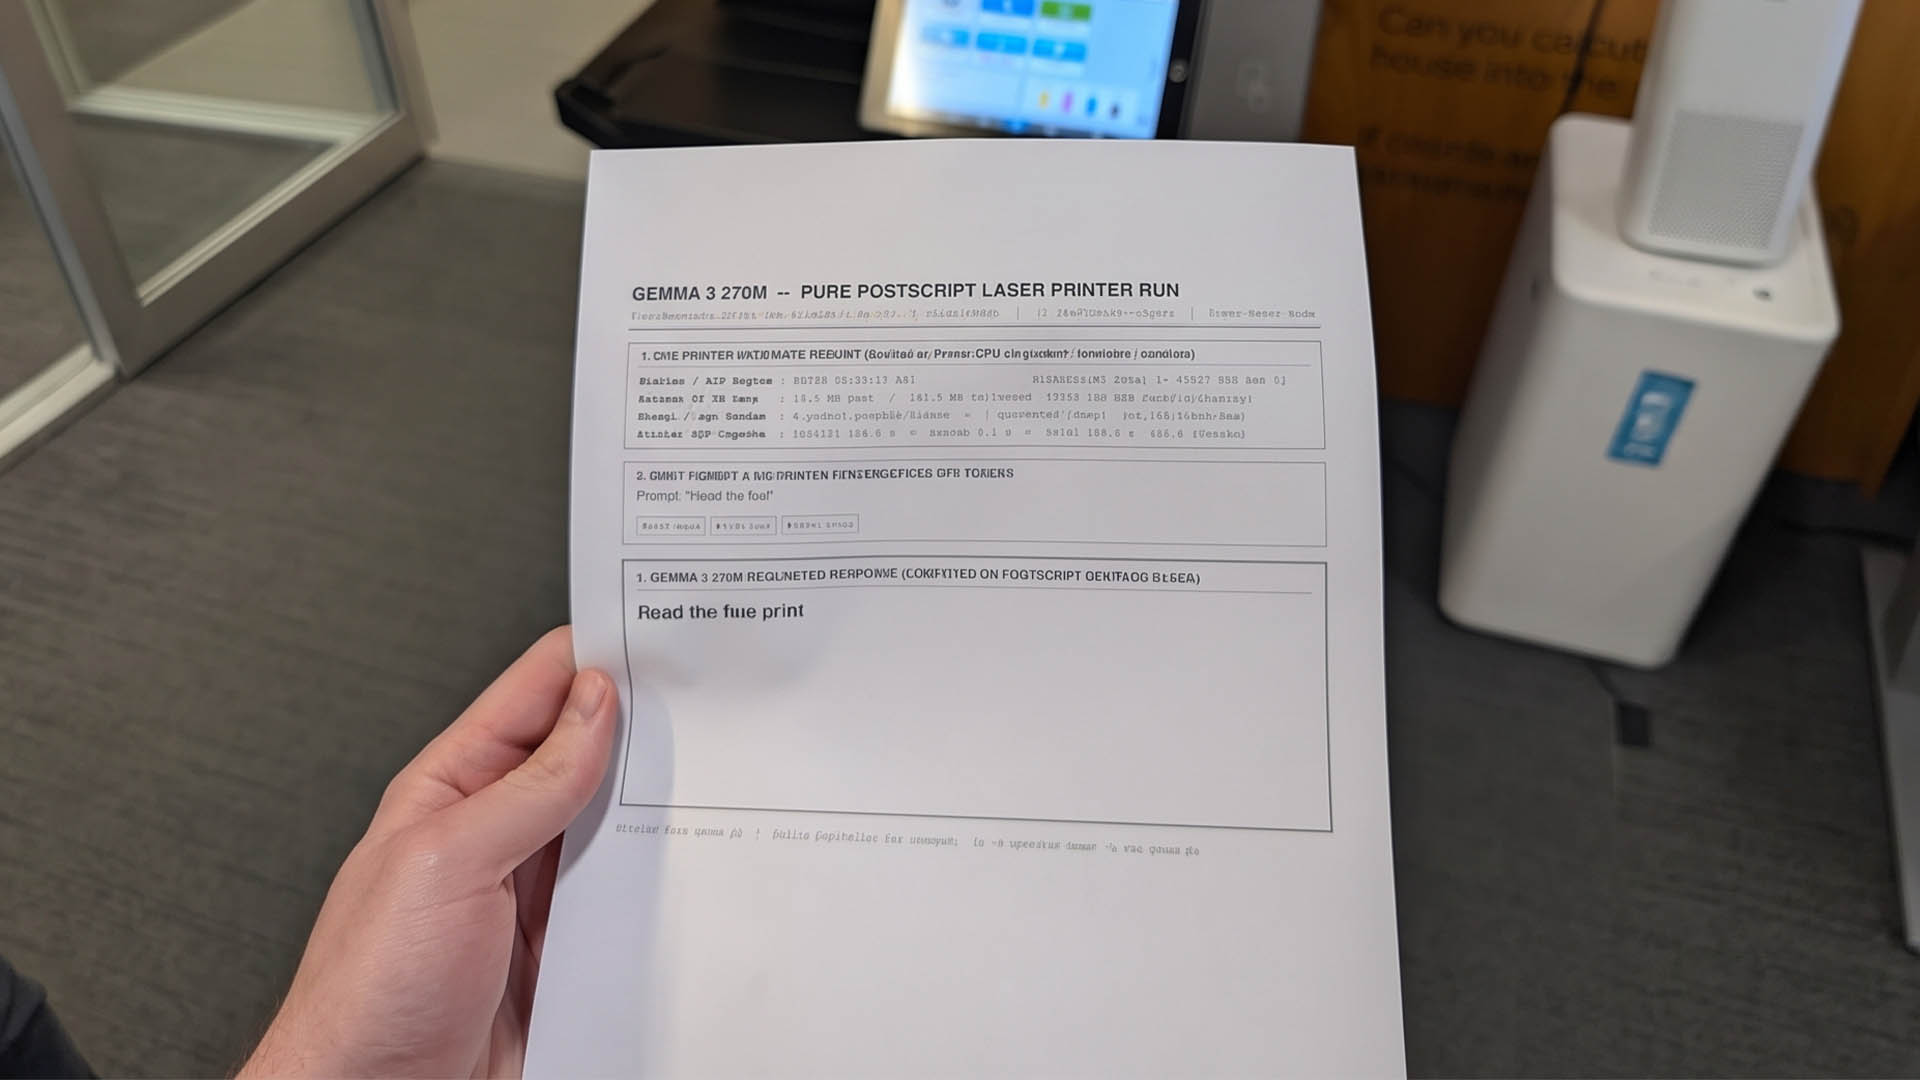
이 결과는 엔지니어 Omar Sanseviero가 소셜 플랫폼 X에서 발표한 것입니다. 그는 Carbon 프로젝트의 도움으로 사무용 프린터에서 직접 Gemma 모델을 실행했다고 말했습니다. 전체 실험에서는 프린터 펌웨어를 수정하지 않았으며 외부 컴퓨팅 보드 또는 기타 하드웨어를 사용하지도 않았습니다. 대신 최신 레이저 프린터에 내장된 PostScript 페이지 설명 언어에 전적으로 의존했습니다.
PostScript는 프린터가 텍스트, 그래픽 및 페이지 레이아웃을 표시하는 방법을 제어하는 데 일반적으로 사용되는 Turing-complete 페이지 설명 언어입니다. 실험팀은 경량 Transformer 추론 엔진인 Carbon을 사용하고 이를 양자화된 Gemma 3 270M 모델과 결합하여 최종적으로 원본 PostScript 인쇄 파일을 생성했습니다. 프린터가 파일을 실행할 때 실제로 PostScript 인터프리터 내에서 언어 모델의 추론 계산을 완료합니다.
모델 추론 중 프린터 메모리 부족을 방지하기 위해 실험에서는 동적 층류 로딩 기술을 채택했습니다. 시스템은 모델의 다양한 레이어를 메모리 안팎으로 지속적으로 로드하여 최대 메모리 사용량을 14.1MB로 유지하는 반면 프린터는 244.6MB의 PostScript 가상 메모리를 할당합니다. 그럼에도 불구하고 Gemma 3 270M은 여전히 프린터 CPU에서 61.3 토큰/초의 생성 속도를 달성했습니다.
실험에서 포착한 하드웨어 정보에 따르면 이 Ricoh 프린터는 기본적으로 PostScript Level 3 인터프리터 내에서 18계층 Transformer 계산을 수행합니다. 토큰 4개만 포함된 '벌금 읽기' 프롬프트가 입력되면 사전 채우기 단계는 184초가 소요되는 반면, 단일 토큰을 생성하는 데 걸리는 디코딩 시간은 0.1초에 불과하며 전체 처리 과정은 총 184초가 소요됩니다.
계산이 완료되면 프린터는 마침내 세 단어로 된 답변인 '세세한 글자를 읽으세요'를 종이에 직접 인쇄합니다. 이 결과는 모델이 실제로 프린터 내부의 추론을 완성했음을 증명할 뿐만 아니라 소프트웨어 수준에서 일상 사무기기의 잠재력이 사람들의 기대를 훨씬 뛰어넘는다는 것을 보여줍니다. 이 작동 모드는 실제 생산 환경에는 적합하지 않지만 소규모 정량 모델, 추론 엔진 및 기존 하드웨어 기능을 결합할 때 가능한 경계를 보여줍니다.
댓글