요약:
Google은 Gemini 4 시리즈의 새로운 제품인 Gemini 4 Neon을 공식 출시했습니다. 이 모델은 복잡한 프로그래밍, 분석적 추론 및 다단계 작업 실행에 적합하며 높은 수준의 지능과 운영 효율성 간의 균형을 유지하려고 노력합니다. 구글은 초기 테스트에서 네온의 전반적인 품질이 플래그십 모델인 제미니 4 카본(Gemini 4 Carbon)을 충족하거나 능가하지만 작업 수행 속도는 3배 더 빠르며 동일한 작업 비용은 카본의 60%에 불과하다고 밝혔습니다.
이전에 Google은 일상 작업을 위한 Gemini 4 Carbon 및 Gemini 4 Hydrogen을 출시했습니다. Carbon은 주로 복잡하고 장기적이고 어려운 작업을 목표로 하는 반면, Hydrogen은 빠른 응답과 일상적인 사용을 강조합니다. 이번에 출시된 네온은 강력한 추론 능력이 필요하지만 실행 속도와 비용에 민감한 서비스 시나리오에 초점을 맞춰 둘 사이의 포지셔닝 격차를 메운다.
Gemini 4 Neon은 인공 분석 지능 지수 평가에서 61점을 획득하여 최고 수준의 xhigh 사고 모드를 켰을 때 3위를 기록했으며, 이는 일부 크고 느린 모델에 이어 2위를 차지했습니다. Vals Index 리뷰에서는 70.9%의 점수로 2위를 차지했습니다. 또한 Google은 Neon이 다단계 명령 실행, 복잡한 제약 조건 처리, 사용자가 작업 요구 사항을 중간에 수정할 때 적응성 측면에서 탁월한 성능을 발휘한다고 밝혔습니다.
소프트웨어 개발 분야에서 Neon은 장기 실행 지능형 에이전트 워크플로에 특히 중점을 두고 있습니다. 여러 파일에 걸쳐 코드 디버깅, 리팩토링 및 프로젝트 수정을 처리하고 작업 진행 상황을 지속적으로 보고하는 동시에 실행 중에 반복되는 파일 읽기를 줄입니다. 구글은 이러한 개선을 통해 모델이 코드를 생성할 수 있을 뿐만 아니라 실제 소프트웨어 개발에 가까운 환경에서 독립적으로 복잡한 작업을 완료할 수 있기를 바라고 있습니다.
구글이 발표한 테스트 결과 인공분석 코딩 에이전트 지수에서 네온은 58.6점을 기록했고, 터미널벤치 4.1은 65.2%, 프론티어코드 2.0은 46.2%를 기록했다. SWE-sweep 테스트에서는 mini-SWE 테스트 프레임워크를 사용할 때 점수가 12.8%였으며, GoogleAntigravity 환경에서는 점수가 39.0%로 증가했습니다. 이러한 차이점은 지능형 에이전트가 사용하는 소프트웨어 프레임워크 및 실행 환경이 최종 결과에 상당한 영향을 미칠 수 있음을 보여줍니다.
Neon은 Antigravity에서 코디네이터 역할을 하여 복잡한 작업을 분할하고 병렬 실행을 위해 여러 Gemini 4 Hydrogen 하위 에이전트에 넘겨줄 수도 있습니다. 이러한 방식으로 모델은 서로 다른 코드 모듈이나 작업 단계를 동시에 처리한 다음 각 하위 에이전트의 결과를 통합할 수 있습니다. 여러 파일과 여러 기능 모듈이 포함된 개발 작업의 경우 이러한 협업 방식을 통해 전체 실행 시간이 단축될 것으로 예상됩니다.
기업 지식 작업 측면에서 Neon은 텍스트, 이미지, 오디오, 비디오 등 다중 모드 입력을 지원하며 통합 컨텍스트 창은 최대 100만 개의 토큰을 지원할 수 있습니다. 사용자는 스프레드시트, PDF, 차트, 오디오, 비디오 및 기타 자료를 동일한 작업에 넣을 수 있으므로 모델이 구조화된 결과를 종합적으로 분석하고 생성할 수 있습니다.
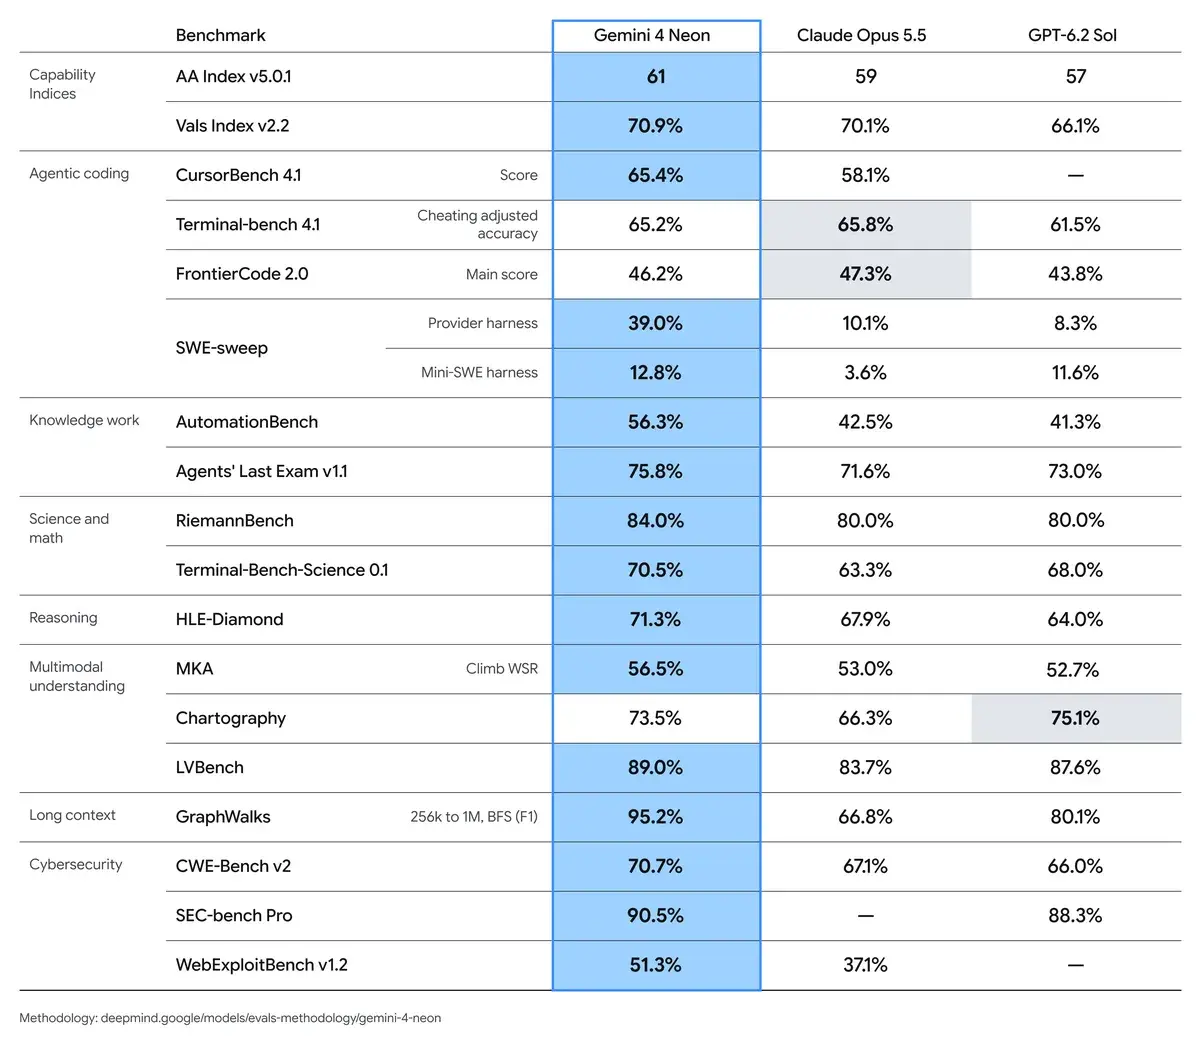
구글이 공개한 테스트 데이터에 따르면 네온은 Vals Index에서 70.9%의 점수를 얻어 법률 연구와 세무 기관 테스트 모두에서 1위를 차지했습니다. Zapier AutomationBench 자동화 작업 테스트에서는 56.3%를 기록했습니다. Andon Labs의 Vending-Bench 2 장기 비즈니스 시뮬레이션에서 시뮬레이션 수익은 $16,843에 도달했습니다. 또한 Chartography 전문 차트 이해력 테스트에서 73.5%, Agents' Last Exam v1.1 테스트에서 75.8%를 기록했습니다.
과학적, 수학적 추론 역시 네온이 집중적으로 강화하는 능력이다. 터미널-벤치 사이언스 테스트에서는 70.5%를 달성했다. RiemannBench 수학 테스트에서는 84.0%를 달성했습니다. HLE-Diamond 테스트에서는 71.3%를 달성했습니다. 이러한 결과는 Neon을 프로그래밍에 적합할 뿐만 아니라 복잡한 과학 연구, 수학적 분석 및 기술 연구 작업을 수행할 수 있는 일반 모델로 자리매김하려는 Google의 열망을 반영합니다.
사이버 보안은 이번 릴리스의 또 다른 초점입니다. Google은 주로 보안 코드 생성, 취약점 발견, 침투 테스트 검증 및 코드 복구에 사용되는 네트워크 보안 작업을 위한 전용 버전의 Gemini 4 Neon을 출시했습니다. AutoBaxBench 테스트에서 이 버전은 어려운 프로젝트에서 76%의 점수를 획득했습니다. WebExploitBench v1.2 테스트에서는 51.26%를 달성했습니다. SEC-bench Pro 취약점 발견 테스트에서는 점수가 90.5%였으며, CWE-bench v2 코드 강화 테스트에서는 70.7%에 이르렀습니다.
Google은 Neon이 네트워크 보안 기능을 개선했지만 여전히 Carbon에 필적하는 심각한 남용 방지 기능을 유지하고 있으며 악성 프롬프트 삽입에 대한 모델의 저항력을 더욱 향상시켰다고 밝혔습니다. 네트워크 보안 전용 버전은 Fairwind 프로그램을 통해 단계적으로 자격을 갖춘 보안 방어자에게 제공될 예정입니다.
보안 및 안정성 측면에서 Google은 특히 장기적이고 다단계 작업을 수행할 때 Neon의 행동 제어를 강조합니다. 회사는 이 모델이 사용자 지침을 더 잘 따르고 허위 결과, 작업 범위의 무단 확장, 요구 사항을 충족하지 않는 지름길 사용과 같은 문제를 줄일 수 있다고 말합니다. 내부 테스트에서 Neon의 행동 지표 중 일부는 이전 Carbon보다 우수했지만 이러한 데이터는 주로 Google의 자체 평가 시스템에서 나온 것이므로 확인하려면 여전히 더 독립적인 테스트가 필요합니다.
가격 측면에서 Gemini 4 Neon이 Gemini API를 통해 제공하는 표준 가격은 입력 토큰 백만 개당 미화 3달러, 캐시된 입력 토큰 백만 개당 미화 0.15달러, 출력 토큰 백만 개당 미화 15달러입니다. 이에 비해 Carbon의 현재 프로모션 가격은 백만 입력 토큰당 2달러 및 백만 출력 토큰당 10달러이지만, 이 제안은 11월 30일까지 지속될 것으로 예상됩니다. 12월 1일부터 Carbon의 표준 가격은 백만 입력 토큰당 US$4 및 백만 출력 토큰당 US$20로 조정됩니다. 이때 Neon의 단일 토큰 가격은 Carbon보다 25% 저렴합니다.
그러나 단순히 토큰 가격을 비교하는 것만으로는 실제 사용 비용이 완전히 반영되지 않습니다. 구글은 네온이 작업을 더 빠르게 완료하고 토큰 소비를 줄여 동일한 작업을 완료할 수 있어 실제 작업량 하에서 단일 작업 비용이 더 낮다고 강조했다. Google이 발표한 데이터에 따르면 기본 High 사고 모드에서 Neon의 작업 완료 비용은 Carbon보다 32% 낮습니다. 더 높은 xhigh 모드에서는 Neon이 여전히 비용 이점을 갖고 있지만 구체적인 범위는 작업 유형 및 모델 구성에 따라 영향을 받습니다.
Gemini 4 Neon은 이제 점차 개방되고 있습니다. 개발자는 Google AI Studio 및 Gemini API의 유료 서비스를 통해 사용할 수 있으며, 기업 고객은 Gemini for Business 및 Antigravity를 통해 액세스할 수 있습니다. 소비자 측면에서는 Google AI Pro 및 Ultra 가입자가 Gemini 앱에서 Neon을 선택할 수 있으며, Pro 및 Ultra 사용자도 Antigravity에서 이를 경험할 수 있습니다.
일반적으로 Neon은 단순히 더 큰 모델 크기나 더 높은 단일 테스트 점수를 추구하는 것이 아니라 실제 사용에서 더 중요한 문제, 즉 대표적인 추론 기능을 갖춘 모델을 더 빠른 속도와 더 낮은 비용으로 실제 작업을 완료하는 방법을 해결하려고 노력하고 있습니다. AI 에이전트를 자주 호출하거나 대규모 코드 기반을 처리하거나 복잡한 사무 작업을 수행해야 하는 사용자의 경우 작업 완료 효율성은 순수 모델 매개변수 및 벤치마크 순위보다 실제적으로 더 중요할 수 있습니다.
댓글