요약:
최근 생성형 인공지능 훈련 데이터의 적법성을 둘러싼 논란이 다시 가열되고 있다. New York Times 저작권 소송에서 공개된 법원 문서에 따르면 Microsoft의 수석 연구 책임자는 내부 토론에서 현재의 대규모 언어 모델 훈련 방법이 "인류 역사상 최대 규모의 노동 절도"일 수 있다고 설명한 적이 있습니다. 관련 발언이 업계의 큰 관심을 끌었다.
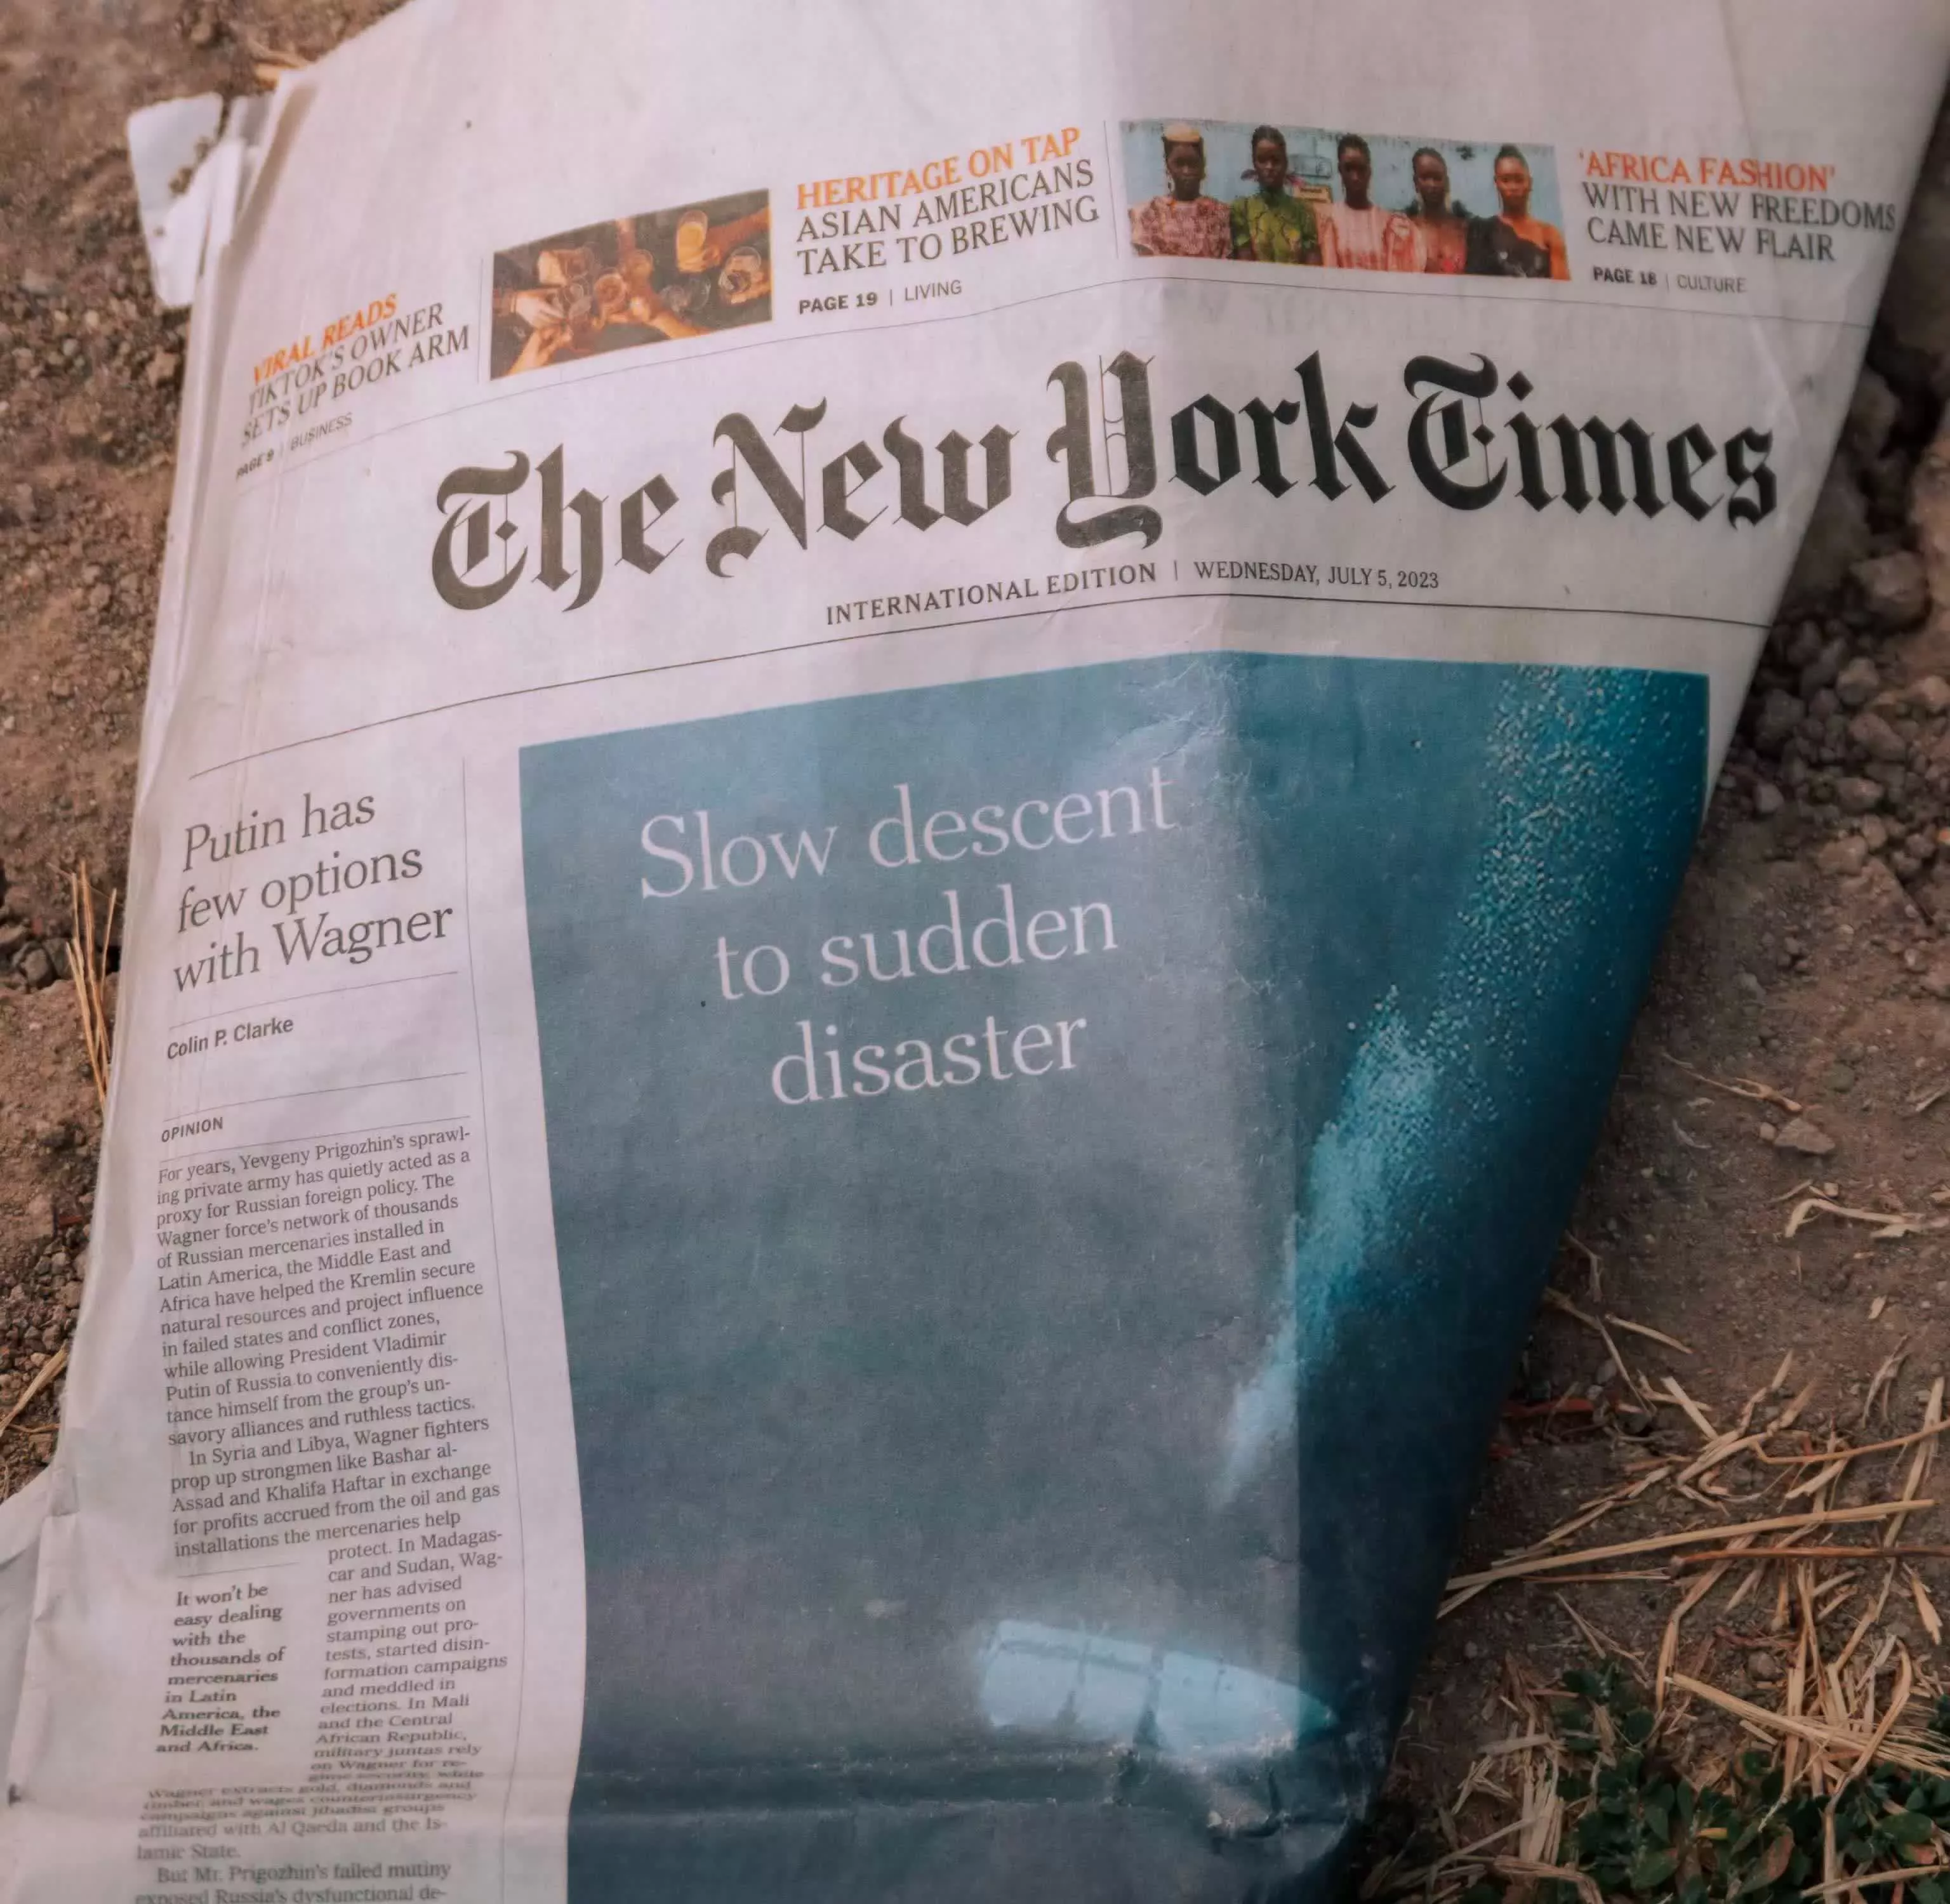
이번에 공개된 발언은 마이크로소프트 응용과학 담당 이사 브렌트 헥트(Brent Hecht)의 발언이다. 최신 공개 법률 문서에 따르면, Microsoft, OpenAI 및 기타 인공 지능 회사가 모델 훈련을 위해 대규모 인터넷 콘텐츠를 사용하는 것에 대해 논의할 때 Hecht는 이 프로세스를 "전례 없는 규모의 놀라운 절도"라고 불렀으며 이것이 "인류 역사상 가장 큰 노동 절도"일 수 있다고 덧붙였습니다.
이 콘텐츠는 New York Times와 기타 뉴스 간행물이 Microsoft와 OpenAI를 상대로 제기한 저작권 소송에 나와 있습니다. 원고는 두 회사가 뉴스 보도 등 저작권이 있는 콘텐츠를 이용해 인공지능 모델을 무단으로 훈련시키고, 이를 상용 제품 개발에 활용했다고 믿고 있다.
Microsoft와 OpenAI는 항상 "공정한 사용" 입장을 고수해 왔습니다. 두 회사는 모델 훈련 과정이 학생들이 지식을 배우기 위해 책을 읽는 것과 유사하며 공정 사용의 범위에 속한다고 믿습니다. 그들은 또한 AI가 생성한 콘텐츠가 직접 복사가 되지 않을 정도로 원본 자료를 충분히 변형했다고 주장합니다.
그러나 새로 공개된 문건 중 일부 내부 소통 기록은 이러한 공개 입장과 뚜렷한 대조를 이루는 것으로 보인다.
문서에 따르면 Hecht는 한때 소송에서 이기려면 관련 회사가 '공정 사용 개념을 완전히 조롱'해야 할 수도 있다고 믿었습니다. 이 진술은 원고에게 중요한 증거로 여겨지며, 인공지능 기업들이 오랫동안 고수해온 저작권 방어 논리에 의문을 제기하는 데 사용된다.
동시에 해당 문서에서는 OpenAI 내부 논의 일부도 공개했습니다. 기록 중 하나는 OpenAI 공동 창립자인 Greg Brockman이 모델이 New York Times 콘텐츠에 노출되었을 때 ChatGPT가 실제로 관련 기사에서 문장을 예측하고 이어갈 수 있었다고 인정한 것을 보여줍니다. 이러한 유형의 콘텐츠는 모델이 학습된 정보를 단순히 추상화하는 것이 아니라 원본 작업을 재현할 수 있는 능력이 있음을 입증하기 위해 원고가 사용합니다.
인공지능 산업의 장기적인 발전에 대한 Hecht의 우려가 저작권 문제 자체에만 국한되지 않는다는 사실도 소송 문서에서 드러났습니다. 그는 또 다른 내부 프레젠테이션 문서에서 소위 "최후의 날 루프" 개념을 제안한 적이 있습니다.
이러한 논리에 따라 인공지능 답변 엔진은 사용자의 뉴스 웹사이트 방문 필요성을 점차 감소시켜 미디어 트래픽과 비즈니스 수익이 감소하고 있습니다. 점점 더 많은 콘텐츠 제작 조직이 생존력을 잃어감에 따라 향후 인공지능 시스템이 학습할 고품질 정보의 출처도 줄어들 것이며, 이는 궁극적으로 모델과 전체 인터넷 생태계에 해를 끼칠 것입니다.
제품이 핵심 공급업체의 경제적 기반을 위협하는 경우는 극히 드물지만 현재 인공지능 산업이 이런 상황에 처해 있다고 내부 문서에서 지적했다. 언론 기관과 콘텐츠 제작자는 AI 모델에 대한 중요한 정보 소스이므로 이러한 그룹이 영향을 받으면 전체 콘텐츠 공급망이 위험에 처하게 됩니다.
원고는 또한 Microsoft의 내부 데이터를 인용하고 Copilot과 같은 AI 응답 시스템이 일부 뉴스 웹사이트의 트래픽에 상당한 영향을 미쳤다고 주장했습니다. 어떤 경우에는 New York Times 페이지를 입력하기 위해 클릭하는 사용자의 비율이 기존 검색 결과에 비해 90% 이상 감소했습니다.
실제로 훈련 데이터의 출처를 둘러싼 분쟁은 현재 인공지능 산업에서 가장 중요한 법적 난제 중 하나가 되었습니다.
OpenAI는 이전에 저작권이 있는 콘텐츠와 접촉하지 않고 고급 인공 지능 시스템을 훈련시키는 것은 거의 불가능한 작업이라고 공개적으로 밝혔습니다. 전 Meta 임원인 Nick Clegg도 유사한 성명을 발표하여 전통적인 저작권 규칙을 엄격히 준수한다면 현재의 많은 AI 시스템이 개발을 유지하기 어려울 것이라고 믿었습니다.
동시에 마이크로소프트, 메타, 기타 기술 기업을 포함한 많은 기업들이 훈련 데이터 소스 문제로 인해 외부 세계로부터 계속해서 비판을 받고 있습니다. 일부 회사는 관련 제작자의 명시적인 승인이나 보상 없이 모델을 훈련하기 위해 사용자 콘텐츠, 코드 라이브러리, 기사, 이미지 및 기타 온라인 리소스를 사용했다는 비난을 받았습니다.
뉴욕타임스 소송이 계속되면서 내부 문서가 공개되는 경우도 늘어나고 있다. 업계 관계자들은 이러한 자료가 마이크로소프트와 오픈AI가 직면한 저작권 소송 결과와 관련이 있을 뿐만 아니라 인공지능 훈련, 지적재산권 보호, 콘텐츠 제작자의 권익 분배에 대한 향후 글로벌 규제 방향에도 영향을 미칠 수 있다고 믿고 있다.
현재 관련 사례는 아직 검토 중입니다. 최종 판결과 상관없이, 인공지능 훈련의 적법성을 둘러싼 이번 법적 분쟁은 향후 AI 산업의 발전 규칙을 결정하는 중요한 이정표가 되고 있다.
댓글