요약:
Elon Musk의 인공 지능 회사인 XAI는 데이터 센터 규모를 더욱 확장하고 있으며 향후 몇 년 내에 120만 개가 넘는 Nvidia AI GPU를 배포할 계획입니다. Colossus 데이터 센터가 계속 확장됨에 따라 xAI는 대규모 컴퓨팅 인프라를 통해 차세대 Grok 모델을 훈련 및 실행하고 OpenAI와 같은 경쟁사와 더욱 치열한 AI 인프라 경쟁을 시작하기를 희망합니다.
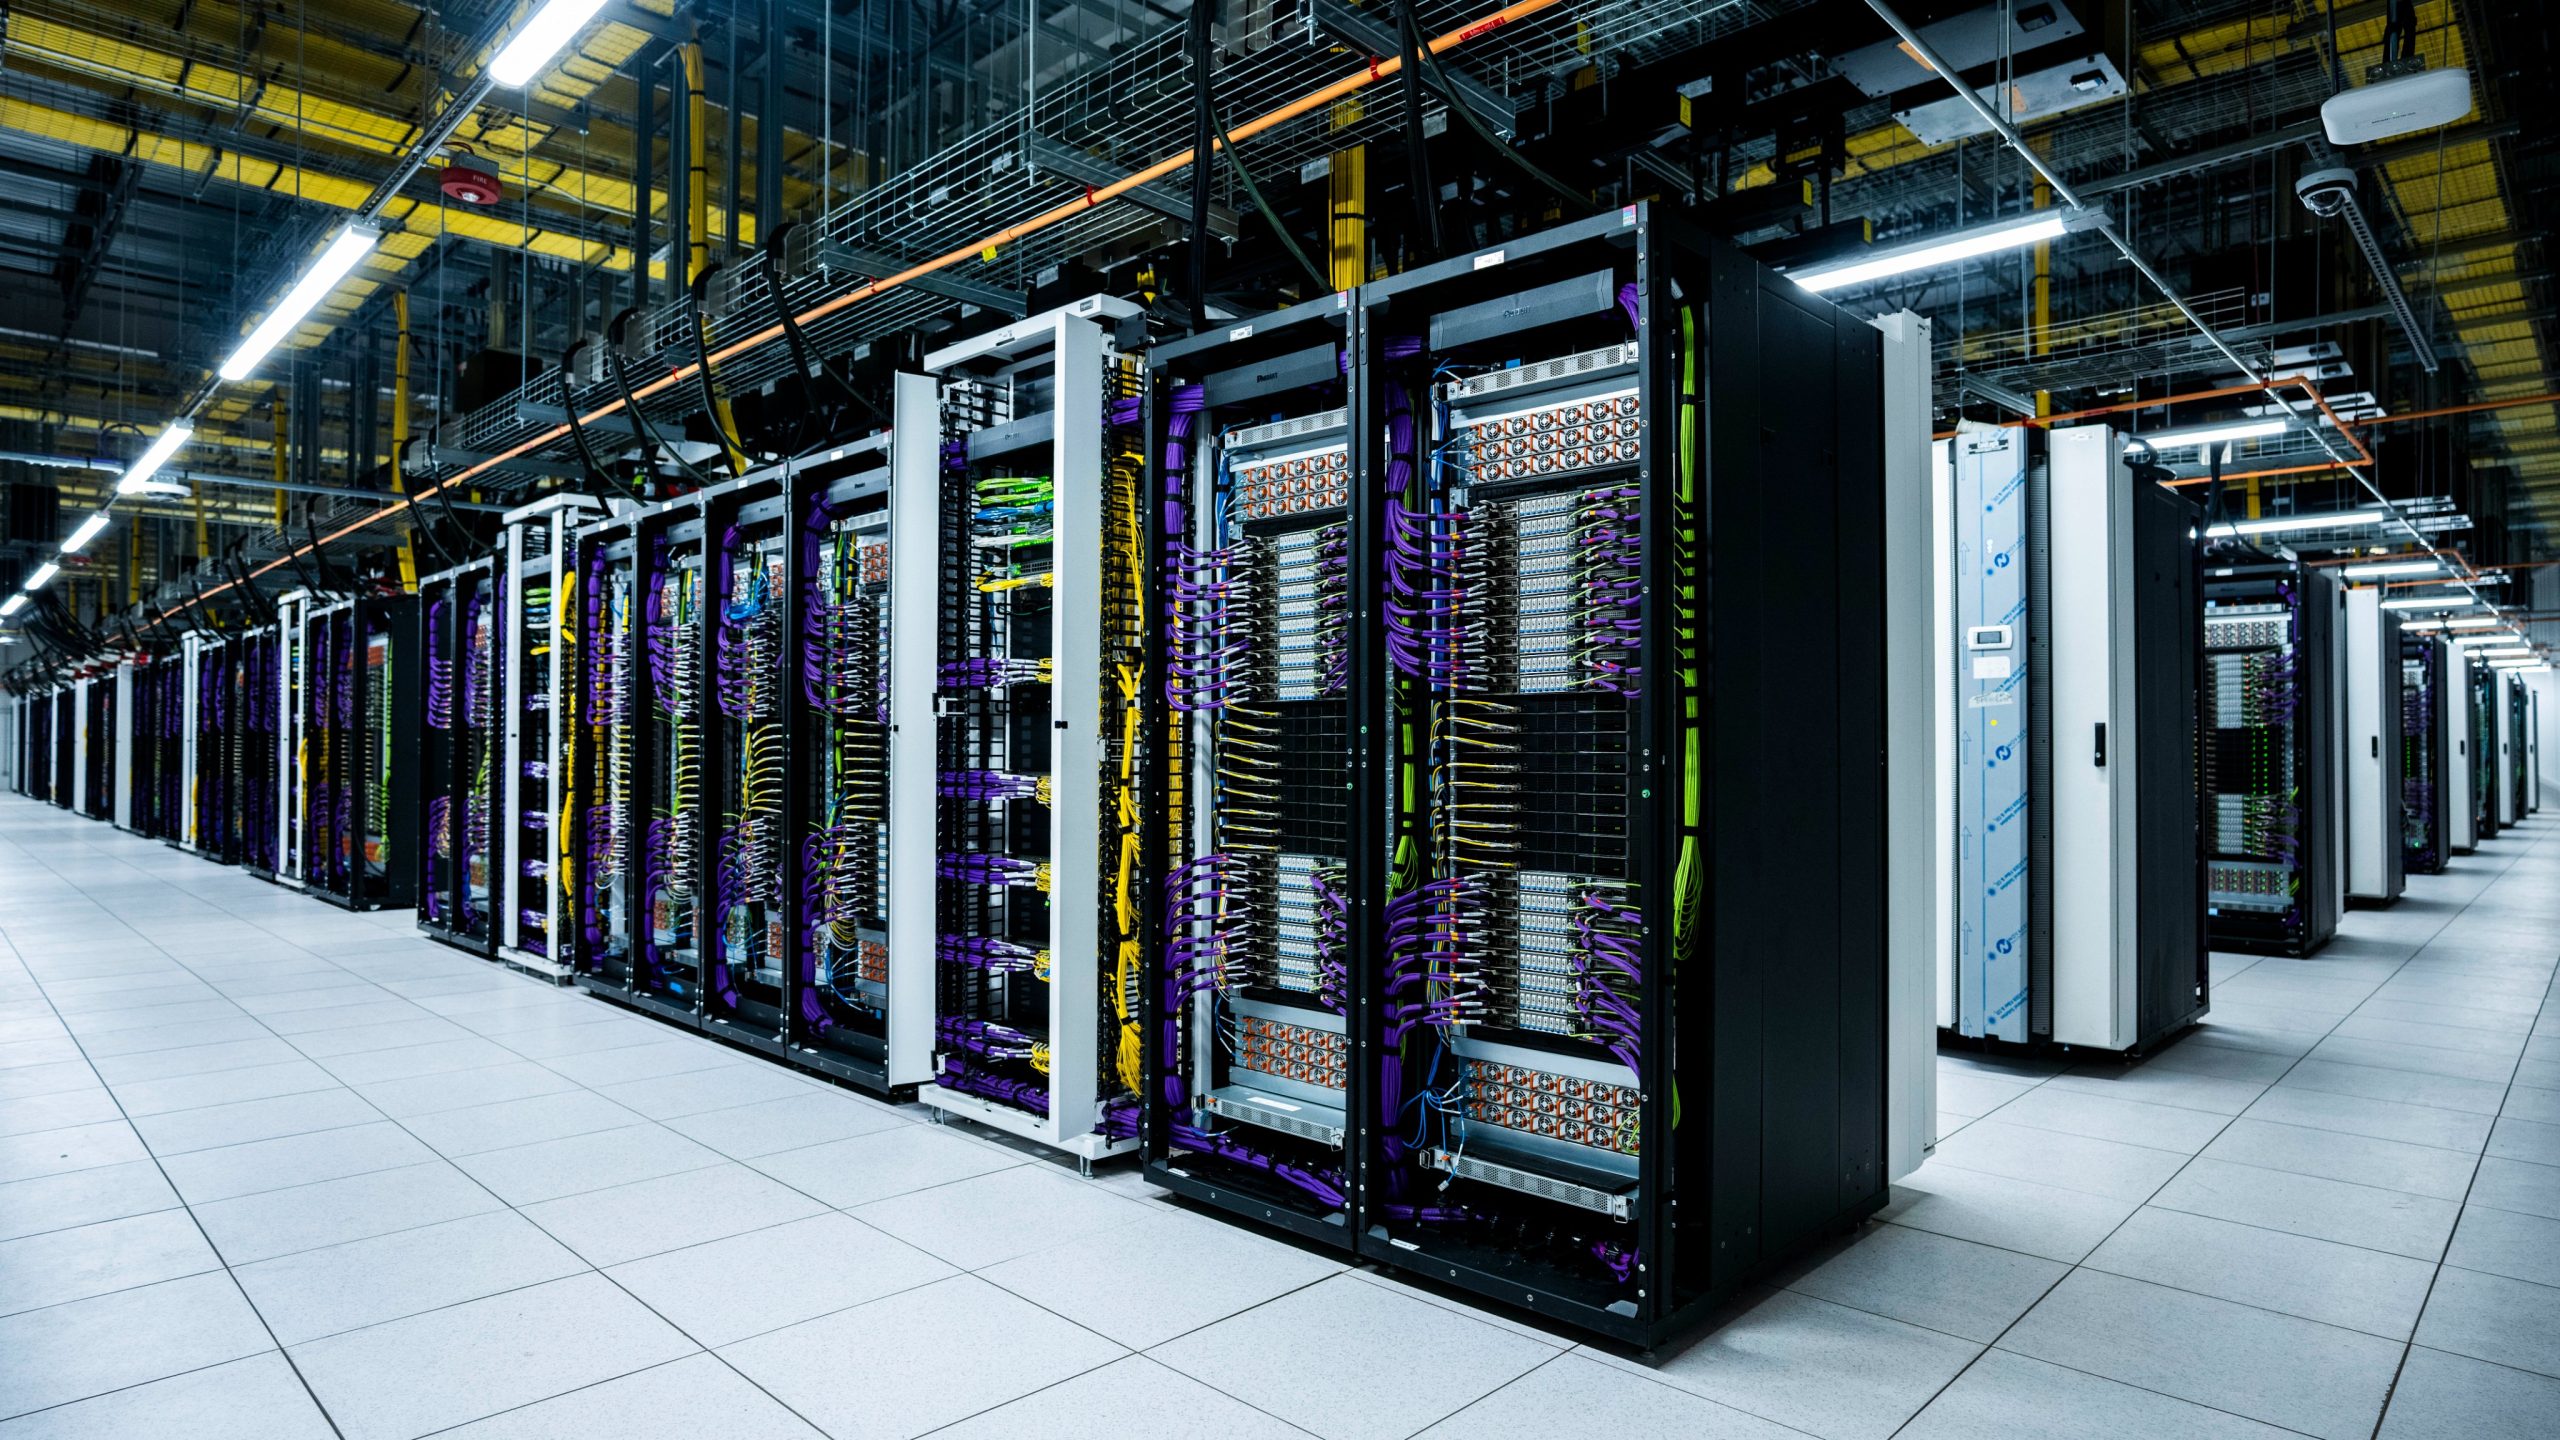
xAI의 현재 가장 큰 AI 인프라 프로젝트는 미국 테네시주 멤피스에 위치한 Colossus 데이터 센터입니다. 프로젝트 건설은 2024년에 시작되며 1단계인 콜로서스 1호(Colossus 1)는 이미 가동 중이다. 머스크는 이전에 Colossus를 xAI의 "컴퓨팅 파워 슈퍼 팩토리"라고 불렀습니다. xAI의 핵심 목표는 가능한 한 빨리 많은 수의 GPU를 중앙 집중식으로 배포하는 것입니다.
Colossus는 처음에 NVIDIA H100 GPU를 사용했습니다. 앞서 발표된 1단계 규모는 H100 약 20만대다. 후속 확장을 통해 데이터 센터는 더욱 발전된 Blackwell 시리즈 GPU를 추가하기 시작했습니다. 최신 정보에 따르면 Colossus 1에는 원래 H100 외에도 약 30,000개의 Nvidia GB200도 배포되어 현재 Colossus 1의 GPU 수가 약 230,000개에 이르렀습니다.
xAI의 두 번째 단계인 Colossus 2는 훨씬 더 규모가 큽니다. 이 프로젝트는 멤피스에도 위치하고 있으며 500,000개 이상의 NVIDIA GPU를 배포할 계획입니다. 현재 계획에 따르면 Colossus 2는 세계 최대의 AI 데이터 센터 프로젝트 중 하나가 될 것이며 컴퓨팅 성능은 기존 슈퍼컴퓨터의 성능을 훨씬 능가할 것입니다.
Colossus 1, Colossus 2 및 후속 구축 프로젝트를 모두 포함하면 향후 사용할 NVIDIA GPU xAI 수는 약 120만 개 이상에 달할 것입니다. 이 숫자는 해당 GPU가 모두 설치되었음을 의미하는 것이 아니라 xAI의 향후 데이터 센터 확장 계획의 전체 규모에 해당합니다.
xAI의 GPU 수의 급격한 확장은 AI 모델 훈련을 위한 컴퓨팅 성능에 대한 수요의 급격한 증가와 직접적인 관련이 있습니다. 대규모 언어 모델의 매개변수 규모, 학습 데이터, 강화 학습 과정에는 점점 더 많은 컴퓨팅 리소스가 필요하며, 모델 학습 및 추론에 필요한 컴퓨팅 파워는 기존 데이터 센터 규모에서 슈퍼컴퓨팅 클러스터 규모로 진화하고 있습니다.
이 경우 GPU를 많이 보유하는 것은 AI 기업이 모델 역량을 확장하는 데 중요한 기반이 되었습니다. Musk는 xAI가 가능한 한 빨리 컴퓨팅 기능을 확장하고 자체 슈퍼컴퓨팅 클러스터를 구축하여 타사 클라우드 컴퓨팅 플랫폼에 대한 의존도를 줄여야 한다고 반복해서 강조했습니다.
Colossus의 건설 속도도 xAI 인프라 전략의 주요 특징입니다. 1단계 데이터센터는 버려진 산업 시설을 기반으로 개조되었으며, xAI는 다수의 사전 제작 장비, 병렬 구축, 신속한 GPU 배치를 통해 단시간에 수십만 개의 GPU를 갖춘 대규모 AI 훈련 시설로 확장했습니다.
xAI는 또한 Colossus의 데이터 센터 구축 및 전원 공급 기능을 지속적으로 확장하고 있습니다. 최신 AI GPU의 전력 소비가 극도로 높기 때문에 데이터 센터 확장은 단순히 서버 수를 늘리는 것이 아닙니다. 또한 동시에 많은 양의 전력, 냉각, 네트워크 및 스토리지 인프라를 구축해야 합니다.
xAI는 이미 이전에도 전원 공급 문제에 직면해 있었습니다. Colossus 1의 전력 소비량은 수백 메가와트에 이르며, GPU 수가 더욱 증가함에 따라 에너지 요구 사항도 크게 증가합니다. xAI는 후속 확장을 지원하기 위해 새로운 전력원을 찾고 이에 상응하는 발전 및 배전 인프라를 구축해 왔습니다.
NVIDIA Blackwell 및 후속 Rubin 시리즈 GPU가 점차 시장에 출시됨에 따라 xAI의 데이터 센터는 하드웨어 업그레이드를 계속할 것입니다. H100과 비교하여 차세대 GPU는 더 높은 AI 컴퓨팅 성능을 제공할 수 있지만 단일 GPU의 전력 소비도 증가하고 있습니다. 따라서 미래의 대규모 AI 데이터센터는 컴퓨팅 밀도와 에너지 공급 문제를 동시에 해결해야 합니다.
Musk는 또한 이전에 xAI가 2027년경에 데이터 센터의 전체 전력 용량을 크게 늘리고 컴퓨팅 성능을 이전 규모의 몇 배로 확장할 계획이라고 밝혔습니다. 관련 계획에 따르면 xAI의 미래 데이터 센터의 총 전력 규모는 수 기가와트 또는 심지어 10기가와트에 이를 수 있습니다.
이러한 거대한 인프라는 xAI가 대규모 클라우드 컴퓨팅 회사와 유사한 AI '슈퍼 팩토리'를 구축하려고 노력하고 있음을 의미합니다. GPU 서버, 네트워크 장비, 스토리지 시스템, 전원 시설 및 액체 냉각 시스템은 Grok과 같은 AI 모델을 훈련하고 실행하기 위한 거대한 컴퓨팅 클러스터로 결합됩니다.
이 전략은 또한 xAI와 OpenAI 간의 경쟁을 점점 더 직접적으로 만듭니다. OpenAI도 최근 몇 년간 대규모로 AI 데이터센터를 구축해 왔으며, NVIDIA와 대규모 인프라 파트너십을 구축했습니다. NVIDIA는 OpenAI에 수백만 개의 GPU에 해당하는 최소 10GW의 AI 시스템을 제공할 계획을 발표했으며, 인프라 구축을 통해 OpenAI에 최대 1,000억 달러까지 점진적으로 투자할 계획입니다.
오픈AI의 계획은 AI 산업이 '기가와트급 데이터센터'를 기본 경쟁력 단위로 삼아 새로운 단계로 진입한다는 뜻이다. 과거에는 AI 기업 간 경쟁이 모델 알고리즘, 인재, 데이터에 더 집중됐지만 이제는 컴퓨팅 인프라 자체가 모델 훈련의 속도와 규모를 결정하는 중요한 요소가 됐다.
xAI는 GPU 배포, 네트워크 구조, 데이터 센터 소프트웨어 및 교육 인프라를 보다 직접적으로 제어할 수 있는 자체 대규모 Colossus 데이터 센터를 구축하기로 결정했습니다. 대규모 모델을 지속적으로 교육해야 하는 기업의 경우 이 접근 방식을 사용하면 외부 클라우드 플랫폼에 대한 의존도를 줄이는 동시에 엔지니어링 팀이 자체 모델에 맞게 하드웨어와 소프트웨어를 최적화할 수 있습니다.
그러나 120만 GPU 규모는 여전히 미래의 목표이지 xAI가 현재 배포한 숫자는 아닙니다. 데이터 센터 구축 속도, GPU 공급, 전원 공급, 냉각 시설, 네트워크 장비, 자본 투자 등이 모두 최종 배포 속도에 영향을 미칩니다. 따라서 실제 실행 중인 GPU 수와 완료 시간은 여전히 다를 수 있습니다.
최종 수치가 현재 계획된 규모에 도달할 수 있는지 여부에 관계없이 xAI가 구축하는 거상은 AI 인프라 경쟁이 새로운 단계에 진입하고 있음을 보여주었습니다. OpenAI, Google, Meta, Microsoft 등 AI 기업들이 기가와트급 데이터센터를 구축함에 따라 향후 AI 모델 간 경쟁은 크게 데이터센터 규모, 전원공급장치, 고급 GPU 확보 역량 간의 경쟁으로 발전할 것입니다.
댓글