요약:
오랫동안 TV든, 모니터든, 스마트폰이든 이미지와 사운드는 서로 다른 위치에서 나오는 경우가 많습니다. 시청자는 화면에서 말하는 캐릭터를 볼 수 있지만 소리는 일반적으로 화면 아래 스피커나 외부 음향 장비에서 나옵니다. 이제 국내 연구팀은 이 문제를 완전히 해결하기 위해 새로운 디스플레이 기술을 개발했습니다. 사진 속 소리 위치에서 소리가 직접 방출되어 더욱 몰입감 있는 시청각 경험을 제공할 수 있게 된 것입니다.
한국기계재료연구원(KIMM) 연구진이 최근 모듈형 그리드 구조를 기반으로 한 '시청각 융합 디스플레이 기술'을 발표했다. 이 기술은 디스플레이 패널 뒷면에 여러 개의 진동 액츄에이터를 설치해 화면 자체가 대형 스피커가 되고, 화면 특정 영역에서 나오는 소리를 정밀하게 제어할 수 있는 기술이다.
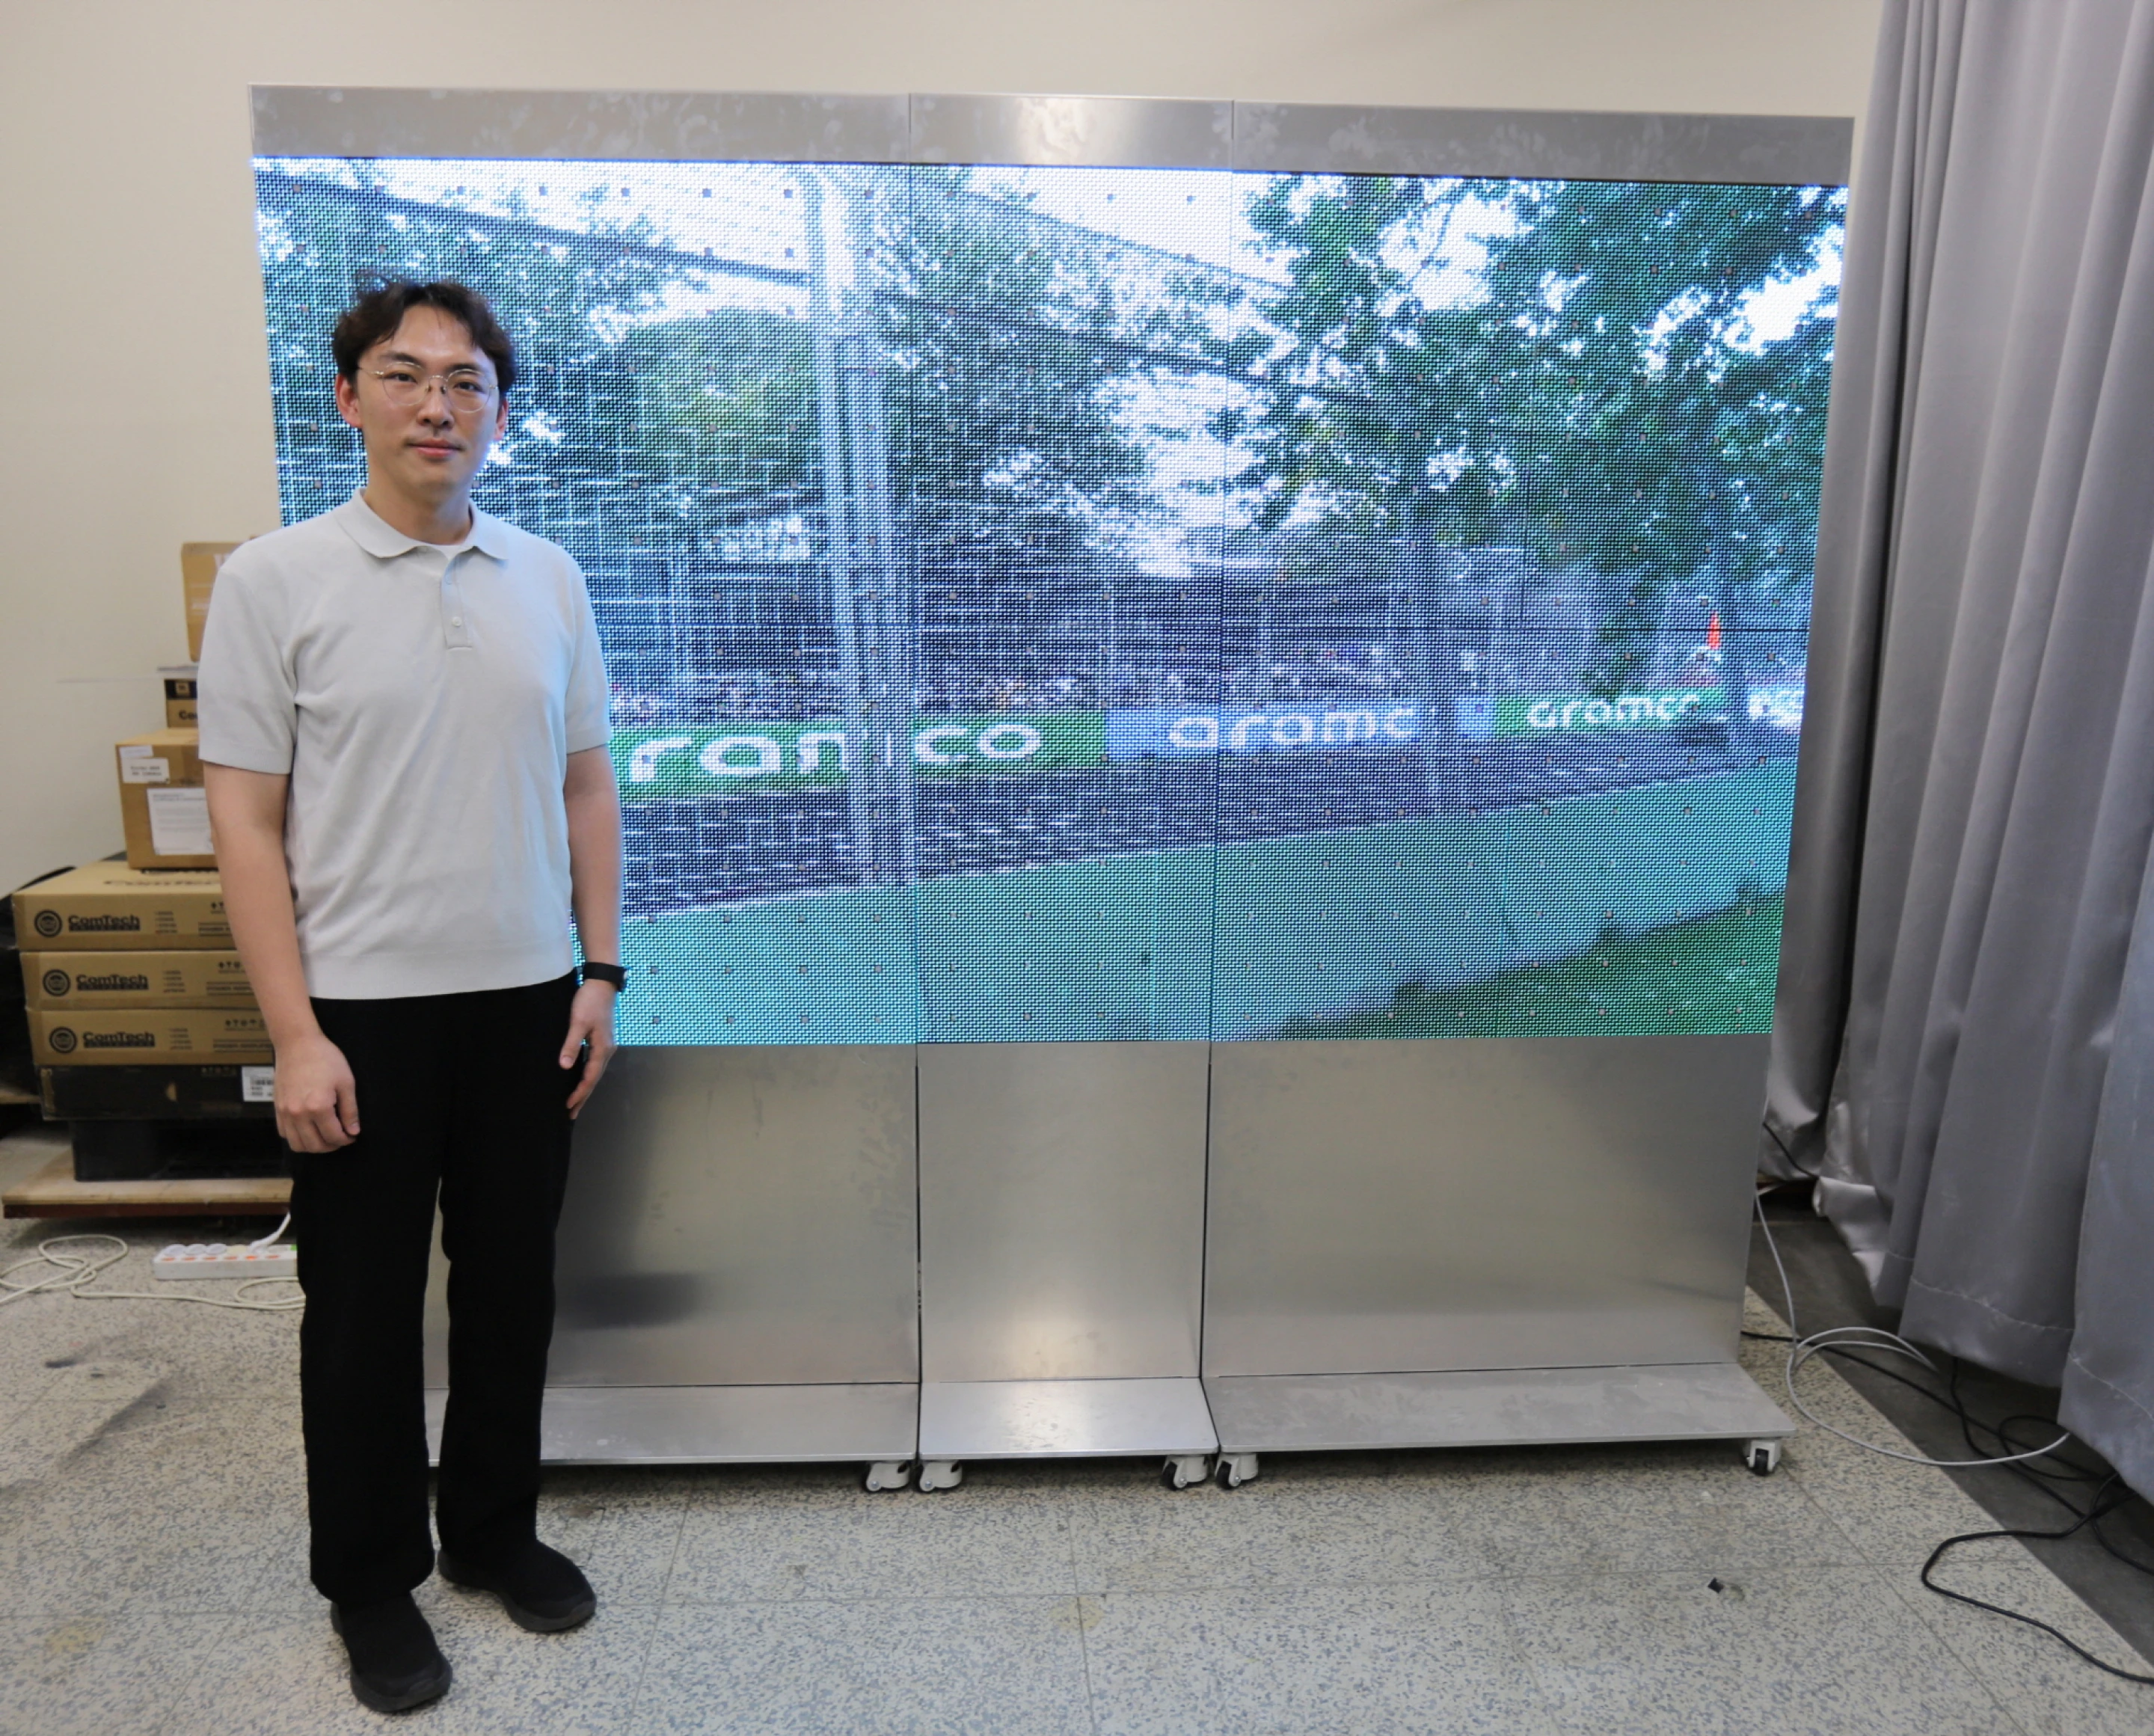
즉, 누군가가 화면 왼쪽 상단에서 말할 때, 그 사람의 목소리는 마치 캐릭터의 입 위치에서 직접 나오는 것처럼 해당 영역에서도 동기적으로 전송됩니다. 사진의 내용이 변경됨에 따라 소리 방출 영역도 실시간으로 이동할 수 있습니다. 예를 들어, 구체가 화면의 한 쪽에서 다른 쪽으로 빠르게 날아갈 때 소리도 같은 궤적을 따라 이동함으로써 공간감과 현실감을 향상시킵니다.
연구원들은 인간이 자연스럽게 음원을 현실 세계의 시각적 대상과 연관시킨다고 지적합니다. 사람들은 떨어진 물체의 위치를 확인할 수 있고 소리 자체가 방향성이 있기 때문에 눈을 감고도 누가 말하는지 알 수 있습니다. 그러나 기존 디스플레이 장치의 시각 정보와 음원은 대개 서로 분리되어 있으며, 이러한 불일치는 항상 몰입 경험에 영향을 미칩니다.
스테레오 및 서라운드 사운드 시스템은 여러 개의 스피커를 통해 방향감을 형성할 수 있었지만 여전히 소리는 주로 화면 주위에 배열된 장치에서 나오며 대형 모니터에서는 화면의 특정 위치에 완벽하게 대응하기 어렵습니다. 이전에는 디스플레이 패널에서 직접 소리를 낼 수 있도록 하는 솔루션이 있었지만, 소리 출력 지점은 일반적으로 고정되어 있고 화면 크기와 주파수 범위에 따라 쉽게 제한됩니다.
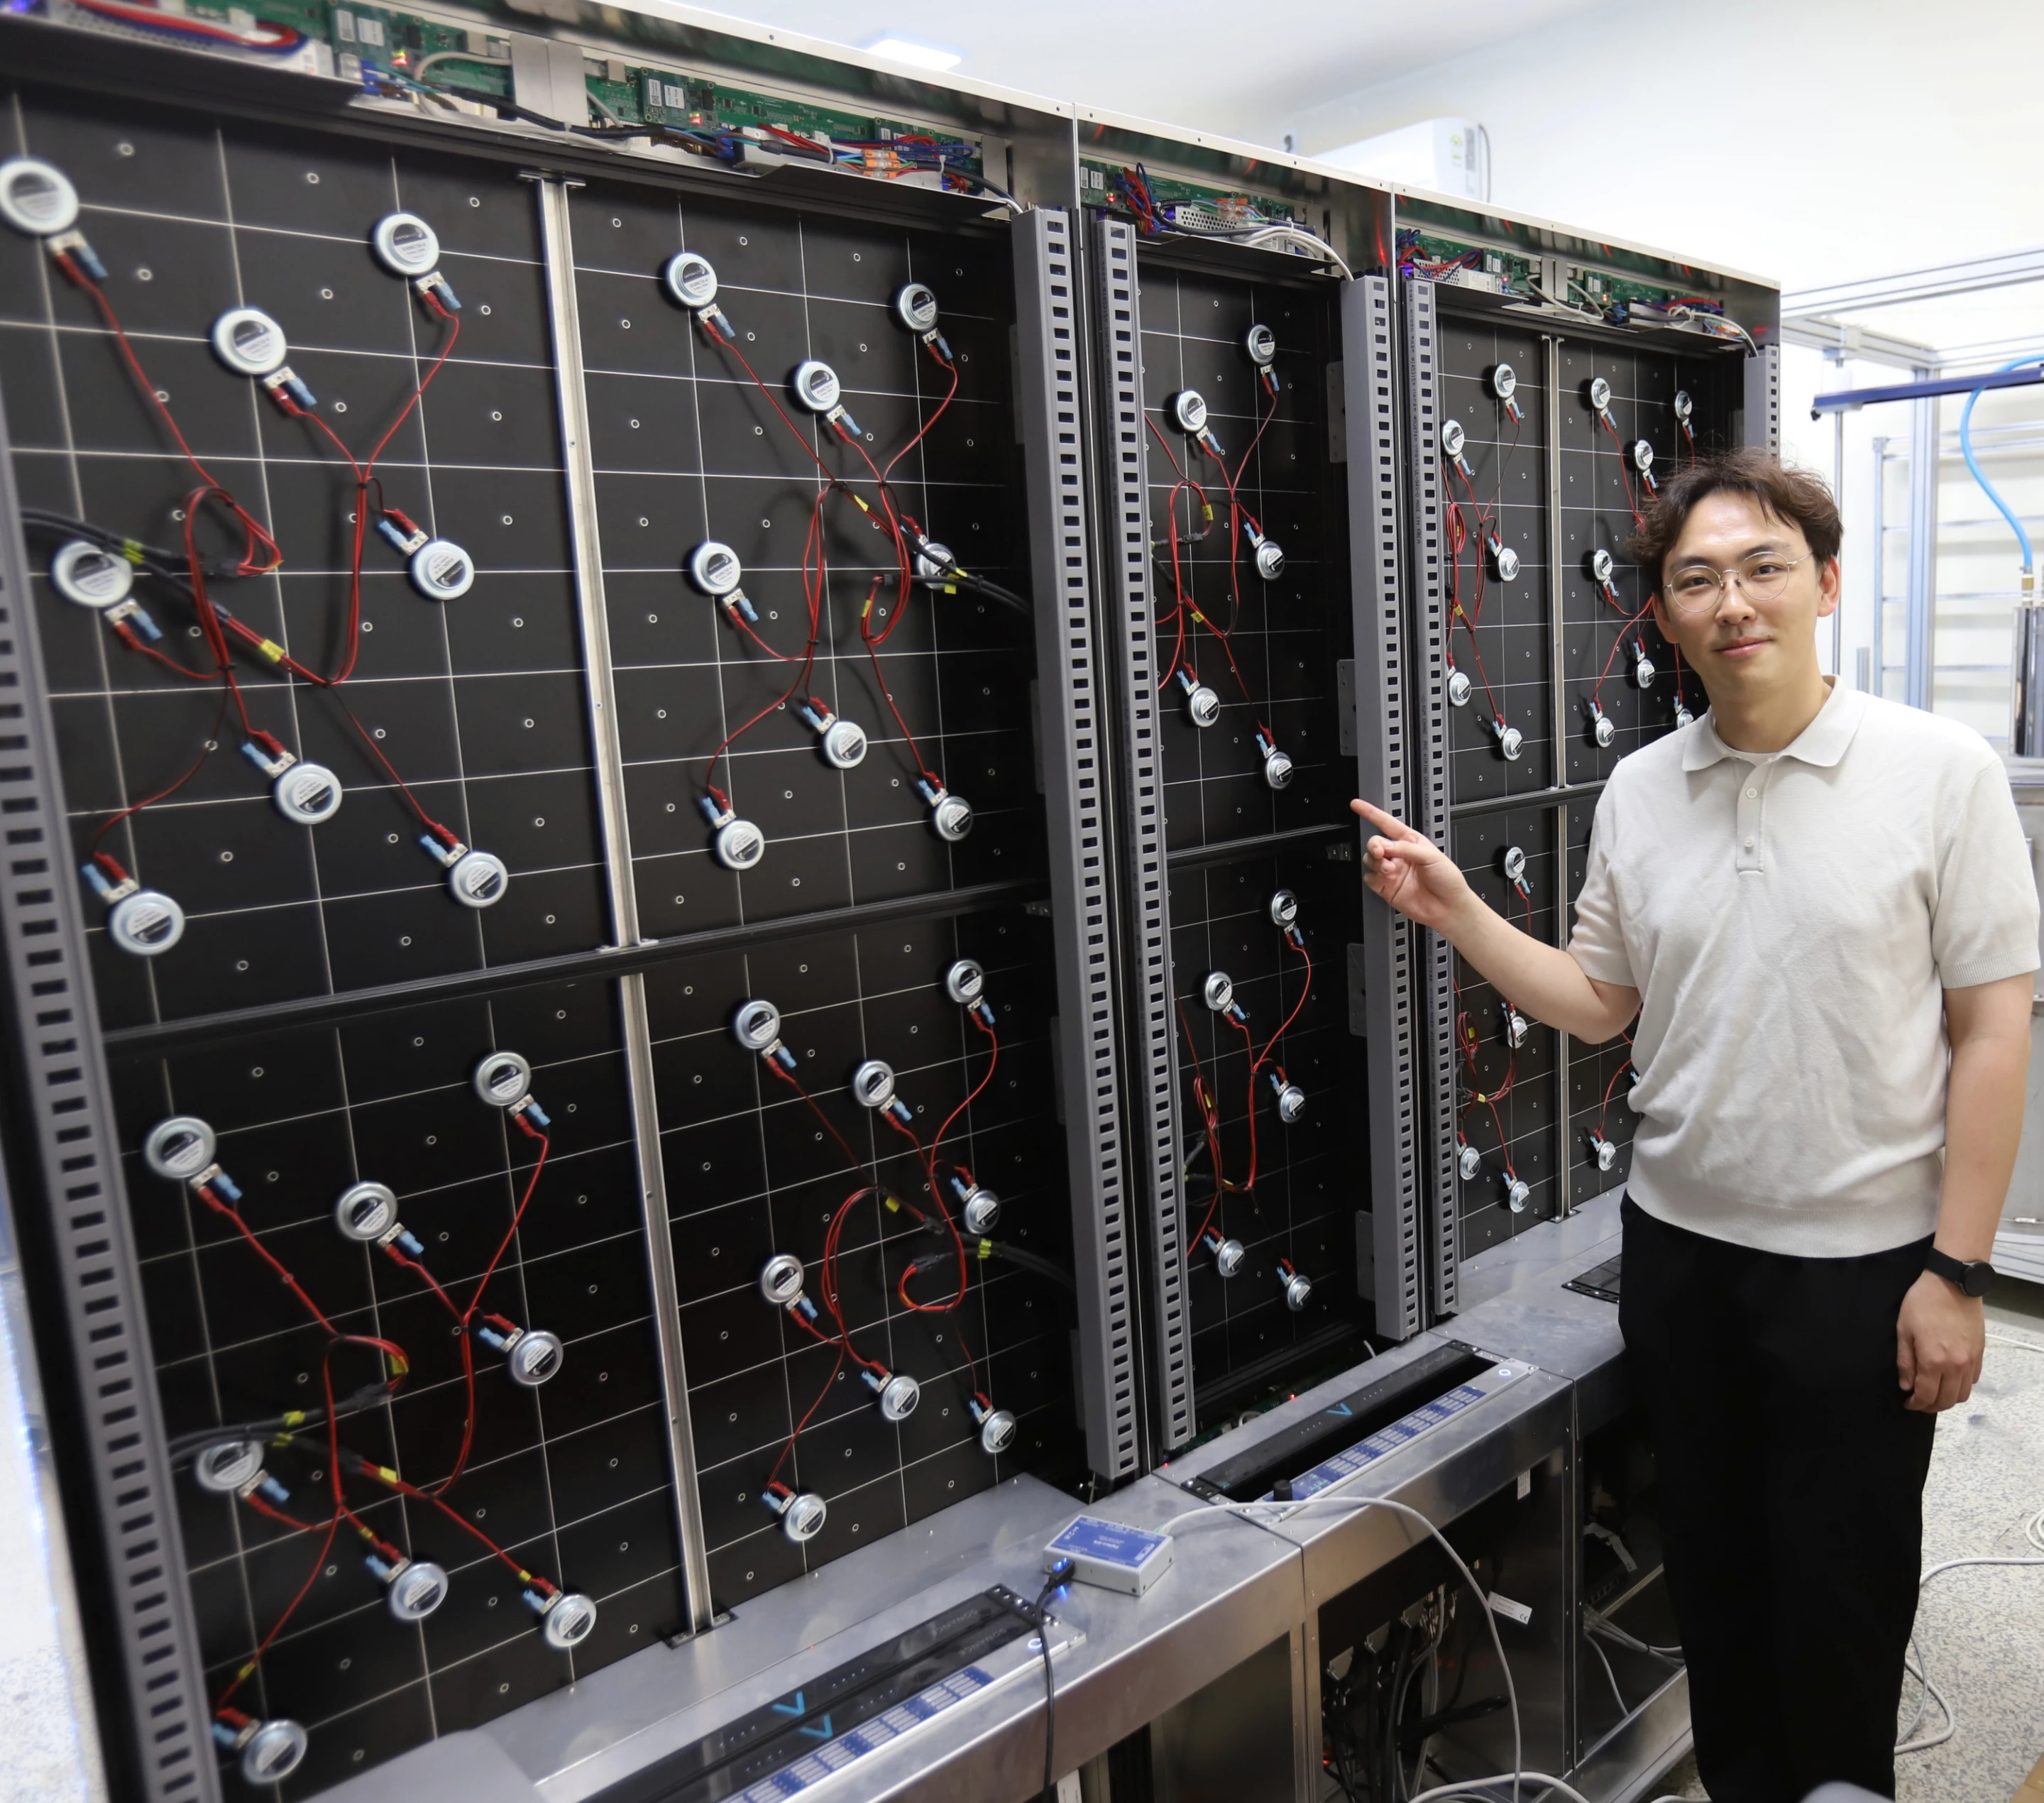
KIMM 팀의 새로운 솔루션은 소리 방출 위치의 동적 제어와 확장 가능한 설계를 달성합니다. 연구진이 제작한 프로토타입 장치는 크기가 약 100인치이며 투명 LED 필름과 알루미늄 패널로 구성되어 있으며 그 뒤에는 80개의 보이스 코일 모터(VCM)가 설치되어 있습니다. 이 모터는 전기 신호를 받은 후 앞뒤로 움직이며 패널이 진동하고 공기를 밀어 음파를 형성하게 됩니다. 원리는 전통적인 스피커 다이어프램의 원리와 유사합니다.
그러나 화면의 특정 영역에 소리를 내는 것은 쉽지 않습니다. 진동은 패널 전체에 전파되어 다른 진동을 추가하거나 상쇄하기 때문에 소리가 나오는 위치를 정확하게 제어하기가 어렵습니다. 연구팀은 이 문제를 해결하기 위해 먼저 패널 각 영역의 진동에 대한 응답 특성을 분석한 후, '무어-펜로즈 유사 역법'이라는 수학적 알고리즘을 사용해 각 모터에 필요한 구동 전압을 계산해 진동 에너지를 대상 영역에 정확하게 집중시켰다.
이 방법은 단순히 가장 가까운 모터를 시작하는 것이 아니라 여러 모터를 사용하여 함께 작동하여 화면에 로컬 진동장을 형성합니다. 비디오의 음원이 움직일 때 진동장도 동시에 움직여 동적 추적 효과를 얻습니다.
실시간 사운드 위치 파악 역시 또 다른 과제에 직면해 있습니다. 패널의 진동파는 서로 영향을 미치며 서로 다른 모터의 서로 다른 영역으로의 전달 효율도 다릅니다. 시스템이 움직이는 대상의 위치를 지속적으로 다시 계산하면 제어 프로세스가 불안정해질 수 있습니다.
이에 연구팀은 진동 전달 효율이 낮은 모터를 계산에서 제외하기 위한 선택적 가진 알고리즘 세트를 개발했으며, 소리 이동 중 소음과 중단을 줄이기 위해 연속 음향 신호를 원활하게 연결할 수 있는 기술도 설계했습니다.
연구원들은 자동화 수준을 더욱 높이기 위해 인공지능 기반 음원 분리 및 위치 파악 기술도 도입했다. AI는 비디오 화면에서 사운드 타겟을 자동으로 식별하고 복잡한 오디오 신호에서 해당 사운드를 추출한 다음 수동 개입 없이 화면의 해당 위치에 정확하게 투사할 수 있습니다.
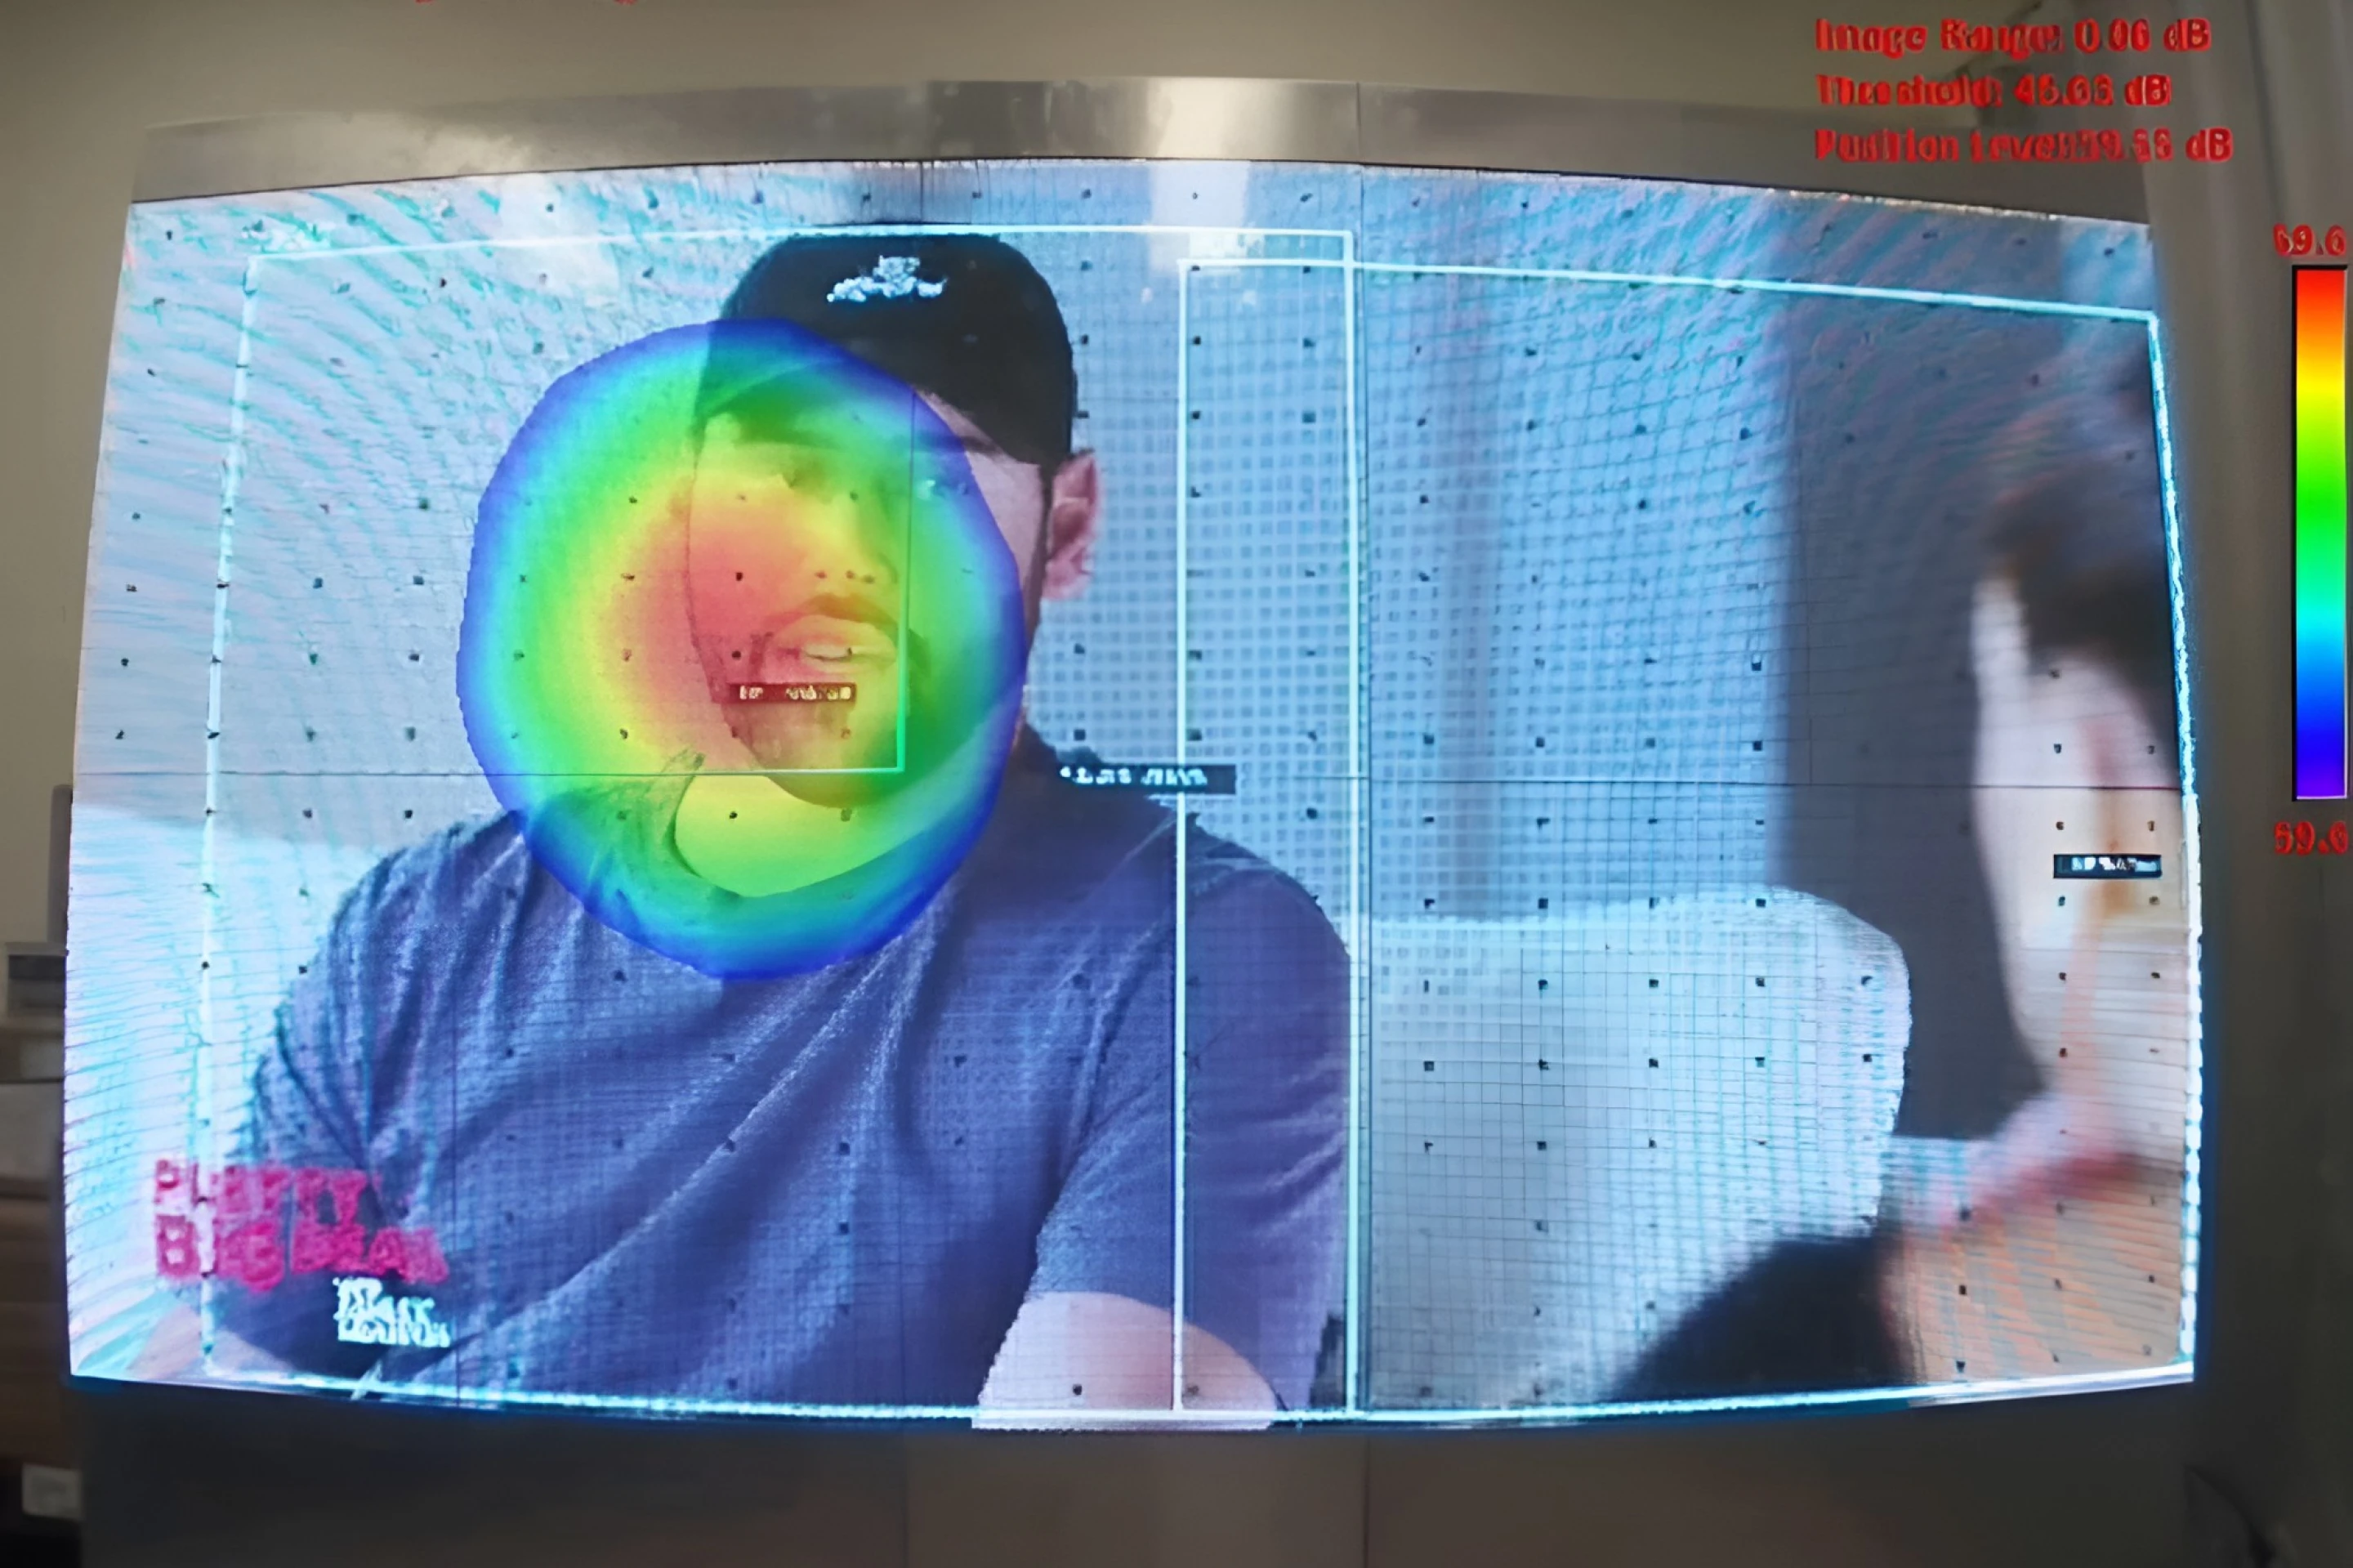
테스트 결과, 프로토타입 시스템은 목표 사운드 영역을 선택하는 데 99.9%의 정확도를 갖는 것으로 나타났습니다. 활성 영역과 비활성 영역의 진동 진폭 차이는 최대 35데시벨에 달해 시스템이 지정된 영역에 진동을 집중시키고 다른 영역의 진동을 효과적으로 억제할 수 있음을 입증합니다. 음향 카메라를 사용한 테스트에서도 사운드 출력 위치가 화면에서 움직이는 대상을 지속적으로 따라갈 수 있음이 확인되었습니다.
관련 연구 결과가 Journal of Mechanical Science and Technology에 게재되었습니다. 현재 이 기술은 500Hz 미만의 저주파 및 중주파 범위에서 우수한 진동장 포지셔닝 기능을 입증했습니다.
다양한 크기의 디스플레이 장치에 적응하기 위해 연구팀은 모듈형 그리드 디자인을 채택했습니다. 여러 디스플레이 모듈은 필요에 따라 자유롭게 결합하거나 분할할 수 있으므로 이론적으로는 가정용 TV에 사용할 수 있으며 대형 LED 디스플레이 벽 및 디지털 간판과 같은 상업용 디스플레이 시나리오로 확장할 수도 있습니다. 연구원들은 또한 여러 모듈이 동시에 작동할 때 시스템이 대형 우퍼와 유사한 저주파 효과를 생성할 수 있다고 말했습니다.
연구팀은 동일한 표면에서 소리와 이미지를 통합하면 청중의 몰입도를 크게 향상시킬 수 있다고 믿습니다. 이 기술은 향후 텔레비전 분야 외에도 미디어 아트, 무대 공연, 전시 디스플레이, 차량 탑재 디스플레이 시스템 등의 시나리오에도 활용될 것으로 기대된다.
박사님 연구과제의 진동준 소장은 “앞으로 이 기술을 모듈형 LED 접합 디스플레이 시스템으로 확대해 다양한 디스플레이 장치에 적합한 차세대 핵심기술로 개발을 추진할 계획”이라고 말했다.
그러나 연구원들은 시스템이 대형 베이스 유닛의 효과 중 일부를 시뮬레이션할 수 있지만 전반적인 음질, 음압 성능 및 전대역 커버리지 기능 측면에서 전문적인 독립 사운드 시스템을 완전히 대체하기는 여전히 어렵다는 점을 인정했습니다. 그럼에도 불구하고, 이 기술은 "한 곳에서는 그림이 다른 곳에서는 소리"라는 오랜 공간적 불일치 문제를 성공적으로 해결하여 화면의 모든 것이 더 현실적이고 자연스럽게 보이도록 만듭니다.
댓글