요약:
DeepSeek에서 V4.1 Flash-1017 대형 모델을 출시했습니다. 시장이 전반적으로 국내 대형 AI 모델의 업데이트를 기대하고 있는 가운데 딥식(DeepSeek)이 가장 먼저 새 버전을 출시했다. 이번 업그레이드로 성능이 크게 향상되었습니다.
구체적인 성과 수준과 변화는 이전에 보고된 바 있습니다. DeepSeek이 이번에 흔히 AI 킬링 라인이라고 불리는 파레토 곡선도 공개했다는 점에 주목해야 합니다. V4.1 Flash-1017은 이번에는 신과 같은 수준입니다. 작업당 비용은 Fable, Astra 등 대형 모델의 1/50~1/100에 불과하며 가격 대비 성능 비율은 최소 40~50배 이상 높습니다.
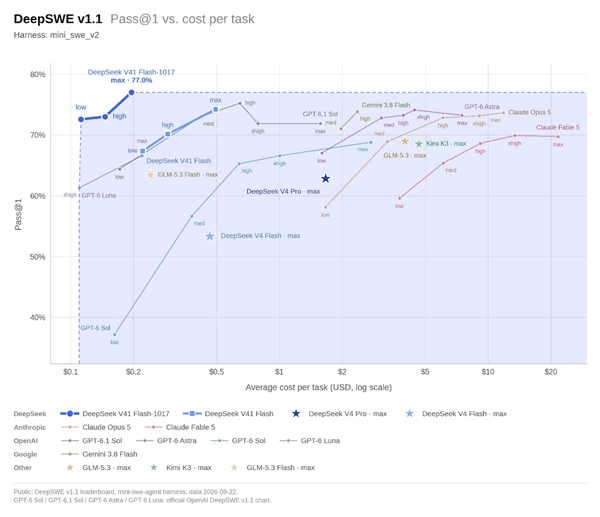
DeepSeek은 어떻게 이러한 킬라인을 달성했나요? 강력한 AI 최적화 역량을 보유하고 있으며 비용 절감을 위해 최선을 다할 수 있다는 것은 누구나 알고 있습니다. vllm_project가 공개한 다음 사진은 DeepSeek가 AI 하드웨어 최적화에 얼마나 강력한지 명확하게 보여줍니다.
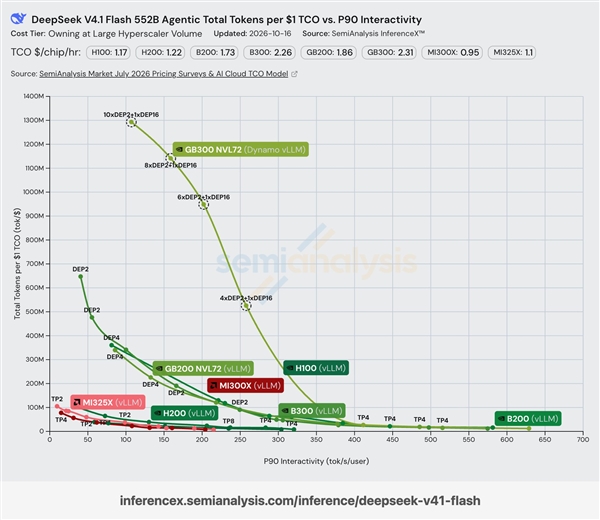
이 사진은 SemiAnalytic AgentX 벤치마크 테스트를 비교한 것입니다. GB300 NVL72 및 Dynamo vLLM 플랫폼에서 V4.1 Flash는 1달러에 13억 토큰을 실행했으며 P90 상호 작용 속도는 사용자당 100톡/초를 초과했습니다.
1 미국 달러는 13억 개의 토큰이므로 1M 토큰의 가격은 US$0.00077에 불과하며 이는 V4.1 Flash의 입력 가격인 US$0.15보다 훨씬 저렴합니다.
물론 이 두 가격을 실제로 그렇게 간단하게 변환할 수는 없습니다. 1 USD 및 13억 개의 토큰에 대한 TCO 비용은 컴퓨팅 성능 측면에 있으며, API 가격 책정은 보다 복잡한 상황을 고려해야 합니다. 그러나 DeepSeek의 초저비용은 이와 관련하여 타의 추종을 불허하는 이점을 제공합니다.
DeepSeek V4.1 플래시는 믿을 수 없을 만큼의 비용 이점을 갖고 있기 때문에 주요 플랫폼은 감히 초저가 요금을 제공하고 있습니다. OpenCode와 CommandCode의 10달러 패키지 사용량은 최근 80~120달러에 이르렀습니다. OpenCode는 지난 이틀 동안 무료로 공개되었습니다. 이제 집계 라우팅 플랫폼에서 V4.1 Flash의 사용량은 1,000억 개의 토큰 수준에 이르렀고, 한 회사는 6~7명의 친구 사용량과 맞먹을 수 있습니다.
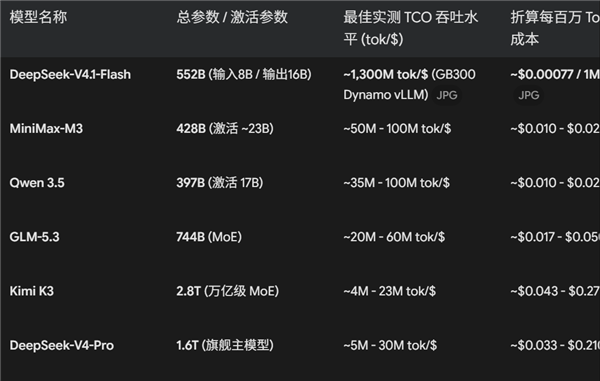
AI가 여러 오픈소스 대형 모델의 TCO 비용을 비교하도록 하세요. 1조 개의 매개변수를 가진 다른 대형 모델의 출력은 최대 V4.1 Flash의 1/10입니다. 매개변수가 1조 5000억~3000억 개에 이르는 대형 모델이라면 비용 차이가 40~50배 이상에 달할 수 있어 비교할 수 없을 만큼 크다.
TCO 비용은 여전히 오늘 출시된 1017 버전이 아닌 V4.1 Flash-0910의 비용이라는 점에 유의해야 합니다. 후자의 API 가격은 변경되지 않았지만 토큰 효율성을 크게 최적화하고 토큰 소비를 줄였습니다. 학위는 업무에 따라 다릅니다. 체성 감각 측면에서는 소비량이 절반 이상 감소했으며 이는 TCO 비용을 다시 크게 줄일 수 있음을 의미합니다.
댓글