요약:
현지 시간으로 11월 9일, Anthropic은 Claude Fable 5.2와 Claude Mythos 5.2를 출시했습니다. 둘 다 동일한 기본 모델을 공유합니다. Fable은 모든 사용자가 사용할 수 있으며 사이버 보안 및 생물학적 보안 보호 기능이 내장되어 있습니다. Mythos는 이러한 제한을 제거하고 사이버 또는 생명 과학 검증 프로그램을 통과한 기관에만 공개됩니다.
출시 후 모든 사람들의 설명은 거의 동일했습니다. 더 강력하고 빨라졌습니다. 일부 개발자는 언뜻 보기에 가격이 잘못되었다고 느끼기도 합니다. 코딩의 경우 Fable 5.2는 비용 효율적이지 않습니다. 그러나 Anthropic 자체는 릴리스 문서에서 대부분의 코딩 및 지식 작업에 대해 모든 사람이 "Claude Opus 5.5로 시작하는 것"을 권장한다고 밝혔습니다.
역사상 가장 강력한 모델들이 끊임없이 업데이트되고 있지만, 사용할 시간이 얼마 남지 않았습니다. AI 기업은 AGI에 도달하기 전에 먼저 상용화의 한계점에 도달했습니다.
강자가 계속 강해지는데, 디지털 인력의 프로토타입이 등장한 걸까요?
먼저 이 제품의 장점에 대해 이야기해 보겠습니다. FrontierCode 2.0은 "오픈 소스 프로젝트 관리자가 모델이 작성한 코드를 병합할 의향이 있는지 여부"를 테스트합니다. 최고 컴퓨팅 성능 수준에서 Fable 5.2는 49.1%를 달성한 반면, 이전 세대 Fable 5.1은 32.4%를 달성했습니다.
모델이 독립적으로 완료할 수 있는 실제 원격 작업 작업 수를 측정하는 원격 노동 지수는 17.9%에서 41.3%로 두 배 이상 증가했습니다.
Anthropic에는 내부 로봇 시뮬레이션 테스트인 RoboDojo Sim도 있는데 점수가 27.6%에서 64.9%로 향상되었습니다. 그러나 이 수치는 회사 내부 운영에서 나온 것이므로 외부 세계에서 재현할 수 없습니다.
그럼 약점이 있습니다. 또한 AutomationBench의 공식 비교표에서는 Fable 5.2의 51.4%가 Google Gemini 4 Carbon의 53.9%에 패했습니다.
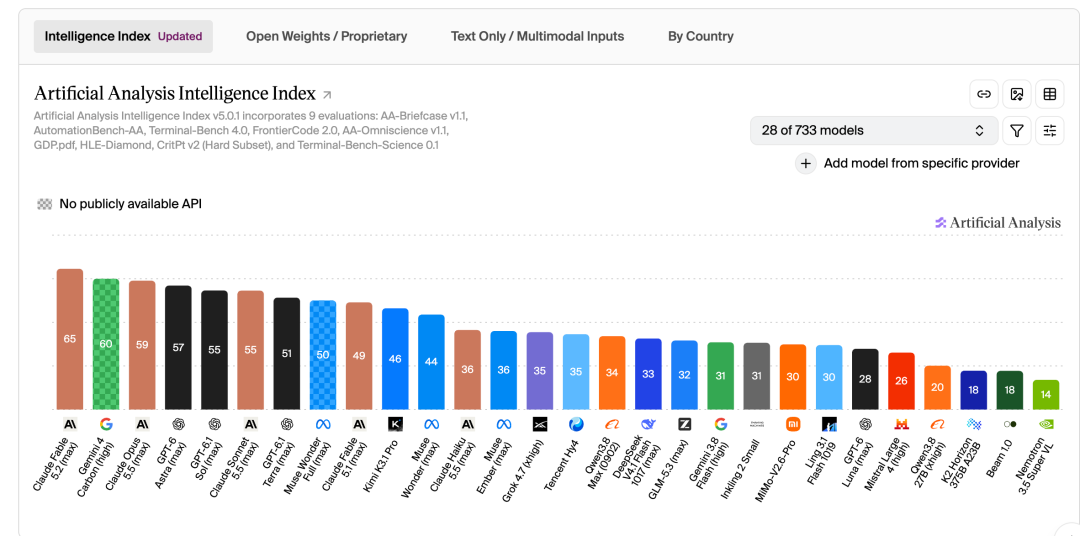
외부 플랫폼 인공분석 스마트리스트에서는 페이블 5.2가 65점으로 1위를 차지해 2위인 제미니 4 카본(60점)을 크게 앞섰고, 4위는 GPT-6 아스트라보다 9점 뒤졌다.
얼마나 강한가요? 하루도 채 지나지 않아 인류 수학 역사상 주요 업적이 직접 완성되었습니다.
30시간 이내에 페르마의 마지막 정리에 대한 공식적인 검증이 완료되었습니다. 또한 블랙홀과 양자 중력과 관련된 물리학의 두 가지 미해결 문제도 해결되었습니다. 또한 운영 체제를 완전히 독립적으로 운영할 수 있고 전자 장비를 독립적으로 설계 및 제조할 수 있으며 복잡한 아데노 관련 바이러스의 캡시드 구조를 예측할 수도 있습니다...
어떤 사람들은 Fable 5.2가 AI가 생산성 도구에서 엔지니어링 실행 기능을 갖춘 디지털 인력으로 이동하고 있음을 의미한다고 믿습니다.
그러나 많은 개발자 그룹은 이것이 Anthropic의 코딩 방향이 "끝났다"는 의미일 수 있다고 믿습니다. 새로운 트랙과 새로운 모델을 개발하지 않으면 투자자의 인식을 자극하기 어려울 것입니다. 그리고 지금은 Anthropic이 IPO 가격 책정을 향해 질주하는 중요한 시기와 일치합니다.
가격이 많이 앞서 있으니 안쓰로픽에서는 사용하지 않는 것을 권장합니다
그러나 많은 개발자들이 Fable 5.2의 기능을 시험해 보고 싶었을 때 가격에 문제가 있다는 사실을 발견했습니다.
Fable 5.2의 표준 가격은 백만 토큰당 입력 8달러, 출력 40달러로, 이전 세대의 10달러와 50달러에 비해 20% 하락한 것으로 보이며, 출력 속도는 5.1보다 최대 30% 빠릅니다. 너무 느리면 고속 모드를 켜면 속도는 2.5배, 가격은 2배로 올라갑니다. 입력은 $16이고 출력은 $80입니다.
직관적으로 인공 분석의 작업당 비용도 훨씬 앞서 있습니다.
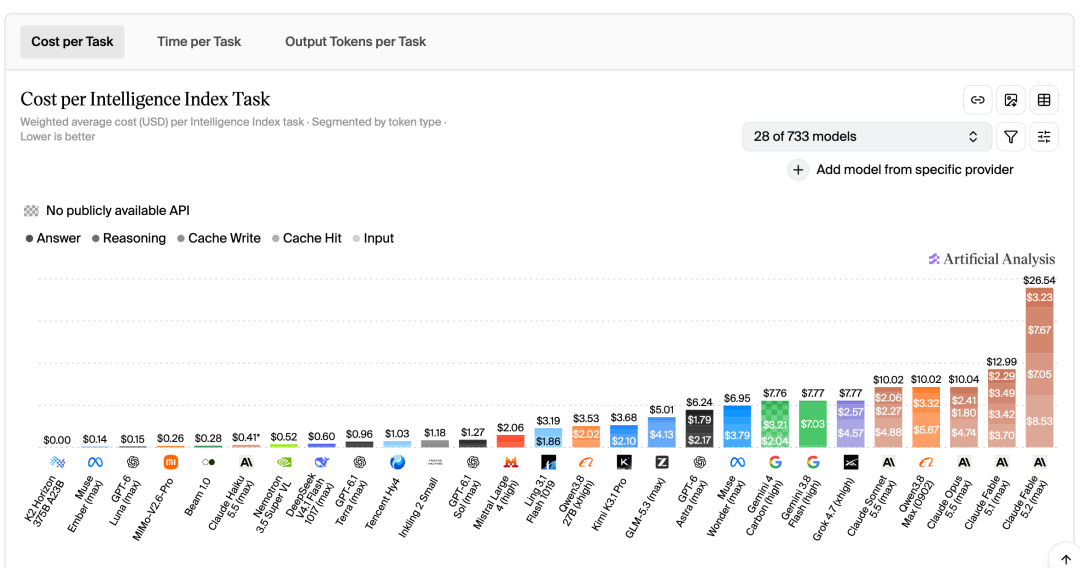
그러나 Anthropic 자체는 릴리스 자료에 "코드 정확도 대 작업당 비용" 곡선을 넣었고 중간 컴퓨팅 성능 수준에서 Fable 5.2의 45.3%는 이미 Opus 5.5의 최고 수준인 45.5%에 가깝고 작업 완료 비용은 약 절반에 불과하다고 결론지었습니다.
현재 Anthropic 관계자는 스마트 소비 측정 척도를 변경했습니다. 지난 2년 동안 업계 가격 비교는 백만 토큰당 비용이 얼마인지를 기준으로 이루어졌습니다. 이번에는 완료된 작업당 비용이 얼마인지로 대체되었습니다. 두 개의 눈금자로 측정한 결과는 완전히 반대일 수 있습니다. 토큰 단가가 20% 더 저렴한 모델은 제대로 작동하는 데 3번의 라운드가 더 소요될 경우 비용이 두 배로 늘어날 수 있습니다.
또한 Anthropic의 공식 권장 사항은 “대부분의 코딩 및 지식 작업의 경우 사용자가 Claude Opus 5.5로 시작하는 것을 권장합니다.”
현재 가격 수준과 비교하면 DeepSeek V4.1-Flash의 비용은 백만 입력당 미화 0.3달러 및 백만 출력당 미화 1.2달러이며, Kimi K3.1 Pro의 비용은 백만 입력당 미화 2달러 및 미화 10달러이며, GPT-5.5 표준 버전의 가격은 미화 5달러 및 미화 30달러입니다. Fable 5.2는 8달러와 40달러로 가장 높은 위치에 있습니다.
즉, 이 모델은 개봉할 때마다 가격이 매우 비싸다는 것입니다. 매일이 아닌 중요한 순간에 한 번 열어보는 것이 그 가치입니다.
이와 관련하여 Anthropic은 두 가지 새로운 역할을 할당했습니다. 하나는 고문입니다. 하이쿠(Haiku), 소네트(Sonnet), 오푸스(Opus) 등 저가형 모델이 문제가 생기면 문의하러 온다. 다른 하나는 스케줄러인 Orchestrator입니다. 개인적으로 하는 것이 아니라 작업을 분할하여 아래의 더 작은 모델에 할당합니다.
최강보다 강한 것은 여전히 갱신되고 있지만 더 이상 가장 중요하지 않습니다
Anthropic은 한 엔지니어가 Fable 5.2에 1,000개 이상의 하위 에이전트를 조정하고 8일 동안 지속적으로 실행되는 빈 폴더를 제공했으며 마침내 자체 커널, 디스크, 키보드 및 네트워크 드라이버, 파일 저장소, 창, 로그인 인터페이스 및 설치 프로그램을 갖춘 노트북에서 부팅할 수 있는 프로토타입 운영 체제를 건네주었다고 말했습니다.
또 다른 에이전트 세트는 Anthropic의 자체 프로덕션 서비스 중 하나를 Python에서 Rust로 마이그레이션했으며, 마이그레이션 후 시작 속도가 약 26배 빨라졌습니다.
하드웨어에도 관련되어 있습니다. Anthropic은 회로 기판 제조업체인 Diode와 협력하여 홈 보이스 어시스턴트, USB 회의 스피커, 회로 기판, 케이스 및 소프트웨어를 포함한 휴대용 전자 애완동물 등 세 가지 제품을 설계했다고 밝혔습니다. 보드는 제작 후 전기적 수정 없이 작동할 수 있습니다.
수학적 샘플은 다음과 같습니다. 약 1,000명의 에이전트가 Fermat의 마지막 정리에 대한 기존 증명을 Lean이 단계별로 검증할 수 있는 형식으로 번역하는 데 30시간도 채 걸리지 않았습니다. 올해 9월에도 같은 일을 하려면 11일이 걸렸고, 특별한 발판과 연구원들의 완전한 지도가 필요했습니다. 이번에는 출력 토큰의 1/3만 사용되었으며, 증명 길이는 원래 길이의 약 1/7이었습니다.
이러한 사례는 과시처럼 들립니다. 그러나 "1000개의 하위 에이전트"를 "1000개의 하위 에이전트"로 바꾸면 실제로 모델이 아닌 조직 구조를 설명한다는 것을 알 수 있습니다.
업계 관계자는 상위 모델 경쟁이 가격 수렴과 데이터 수렴으로 수렴된 것으로 보고 있다. 다음 단계는 의심할 여지 없이 '적용' 단계로, 모델 역량의 상한과 가격의 하한이 동시에 진행되는데, 이는 AI가 다양한 차별화된 탐색에 사용될 수 있음을 의미합니다. 그때쯤이면 모델 제조업체의 경쟁은 하네스, 메모리, 사용자 습관과 같은 차원이 될 것입니다.
이쯤 되면 대형 모델 제조사들이 조율을 하고 있는 모습이 보입니다. 예를 들어 DeepSeek과 OpenAI도 동일한 기능 세트를 완성하고 있습니다.
올해 8월 DeepSeek은 MIT 라이선스에 따라 DeepSeek Harness를 오픈소스화했습니다. 10월 17일 DeepSeek가 V4.1-Flash-1017을 출시하면서 새 모델이 DeepSeek Harness, Tencent CodeBuddy, WorkBuddy와 같은 지능형 제품에 최적화되었음을 분명히 했습니다. 그리고 하네스 팀의 Cui Tianyi는 대규모로 사람들을 모집하고 있습니다. Ifeng Technology는 이전에 업계 내부자로부터 Liang Wenfeng 자신이 "이 분야도 이 분야"에 더 뛰어나다는 사실을 알게 되었습니다.
또한 11월 5일 Kimi는 Harness as a Service를 공식적으로 제안하는 Kimi Hosted Agents(호스팅 에이전트)를 출시했습니다.
같은 날 Anthropic에서 Claude Code 제품을 담당했던 Cat Wu가 OpenAI에 합류하여 핵심 제품팀의 제품 관리를 담당했습니다. 그녀는 Claude Code를 내부 프로토타입부터 널리 사용되는 상용 제품까지 추진하는 데 참여했으며 잠시 후 Cursor에 합류했습니다.
클로드코드는 AI 프로그래밍 시장에서 앤트로픽의 가장 대표적인 제품 중 하나이다. Cat Wu는 제품 구상부터 상용화까지의 과정을 직접 경험했습니다. OpenAI의 그녀 채용은 분명히 Codex 및 더 넓은 Agent 제품의 기능을 강화한다는 것을 의미합니다.
실제로 Fable 5.2 출시 직전에 Gemini의 새로운 모델로 추정되는 것이 '유출'되었습니다. @chetaslua 사용자는 "시간도 두 배, 코드 양도 두 배로 늘어난다"고 댓글을 달았습니다. 이는 Google 내 코드명 "krypton"인 Gemini 4의 새로운 체크포인트입니다. 코드 생성 비주얼과 3D 장면에서의 성능은 새로 출시된 카본을 크게 능가한다고 합니다. 따라서 상위 모델의 새로 고침 속도가 증가하고 있습니다. 어떤 사람들은 이것이 RSI 때문이라고 생각합니다. 그렇지 않으면 설명할 방법이 없습니다.
그럼 질문이 나옵니다. 지능이 더 이상 문제가 되지 않는다면 경쟁력이란 무엇일까요? 다음 모델 경쟁은 어떻게 진행되나요? 답은 곧 공개됩니다.
댓글