요약:
머스크의 인공지능 회사인 xAI는 차세대 대형 모델인 Grok 4.7을 공식 출시하며 현재 가장 강력한 프로그래밍 및 지식 작업 모델로 자리매김했습니다. 신형 모델은 복잡한 작업의 처리 능력을 향상시켰을 뿐만 아니라, 이전 세대 제품과 동일한 동작 속도와 가격 체제를 유지해, 더 저렴한 가격으로 시장에서 경쟁하고 있다고 회사측은 밝혔다.
xAI에서 발표한 정보에 따르면 Grok 4.7은 새로운 대규모 기본 모델을 채택하고 훈련 과정에서 더 긴 강화 학습 최적화를 수행합니다. 이전 버전과 비교하여 새 모델은 더 복잡한 훈련 작업에 노출되어 있으며 완료하는 데 몇 시간 동안 지속되도록 설계된 많은 작업이 있습니다. 이를 통해 모델은 장기적인 추론, 자체 검증 및 복잡한 작업 관리에서 상당한 향상을 달성할 수 있습니다.
xAI는 Grok 4.7의 가장 큰 변화 중 하나가 더욱 강력해진 "자체 테스트 기능"이라고 말했습니다. 모델은 질문에 답하고, 코드를 작성하고, 복잡한 지식 작업을 수행할 때 자체 출력을 보다 적극적으로 확인할 수 있으므로 오류율을 줄이고 최종 결과의 신뢰성을 높일 수 있습니다.
동시에 매우 긴 컨텍스트를 처리하는 새 모델의 능력도 향상되었습니다. 대용량 문서, 여러 라운드의 작업 및 장기간의 프로젝트 작업에 직면했을 때 Grok 4.7은 일부 기존 모델처럼 컨텍스트가 커짐에 따라 명백한 성능 저하 없이 보다 안정적인 정보 관리 기능을 유지할 수 있습니다.
실제 업무 경험을 더욱 향상시키기 위해 xAI는 Grok Bot 운영 프레임워크를 기본적으로 이해하도록 특별히 Grok 4.7을 교육합니다. 이는 일회성 질문 및 답변 시나리오에 적합할 뿐만 아니라 장기 실행 지능형 에이전트로서 워크플로에 참여하는 데 더 적합하다는 것을 의미합니다. 회사는 이것이 일반 지식 작업, 지속적인 대화 및 기업 수준 작업에서 모델 성능을 향상시킬 것이라고 믿습니다.
Grok 4.7은 프로그래밍 기능 외에도 더욱 강력한 문서 및 프리젠테이션 작성 기능을 제공합니다. 관계자들은 이제 이 모델이 전문 보고서, 비즈니스 문서 및 프리젠테이션 자료를 더 잘 생성할 수 있게 되었으며 사무 자동화 분야에서 적용 범위를 더욱 확대할 수 있기를 희망한다고 밝혔습니다.
성능 측면에서 xAI는 일련의 내부 테스트 결과를 발표했습니다.
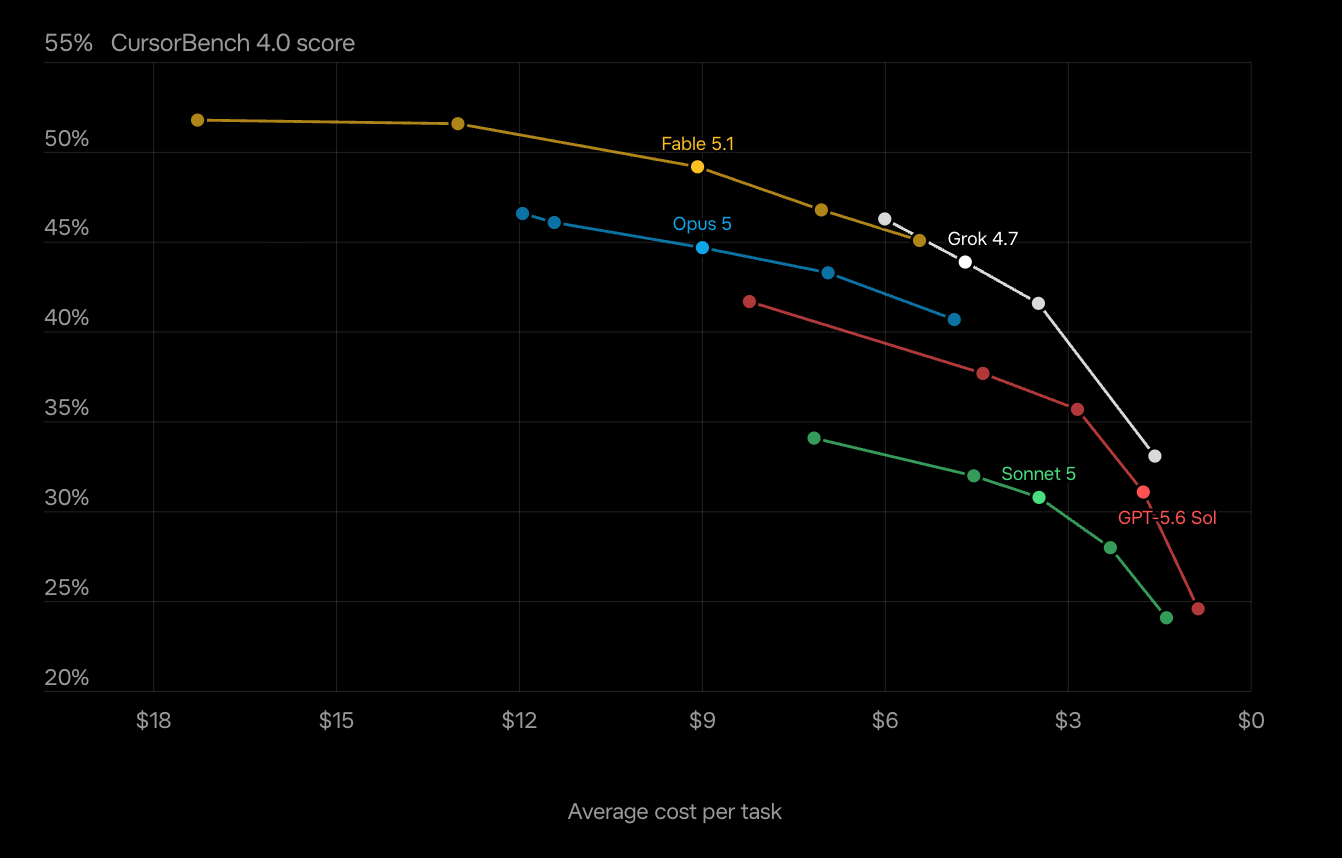
장기적인 소프트웨어 엔지니어링 역량을 평가하는 데 사용되는 CursorBench 4.0 테스트에서 Grok 4.7은 46.3%의 점수를 얻었으며 이는 Grok 4.6의 40.4%에 비해 크게 향상되었습니다. DeepSWE 소프트웨어 엔지니어링 테스트에서 새 모델은 71%의 점수를 달성하여 업계 최고의 제품에 가까운 경쟁력 수준을 계속 유지하고 있습니다.
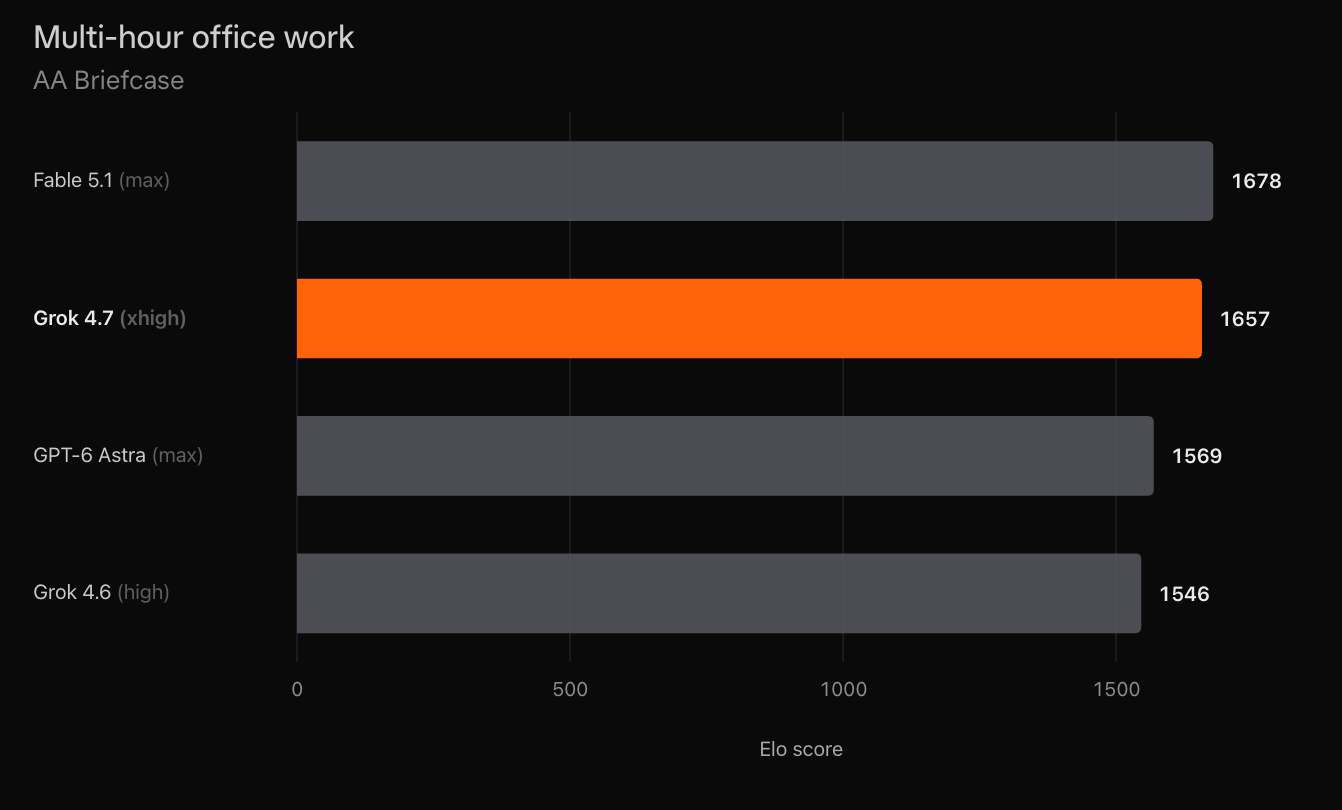
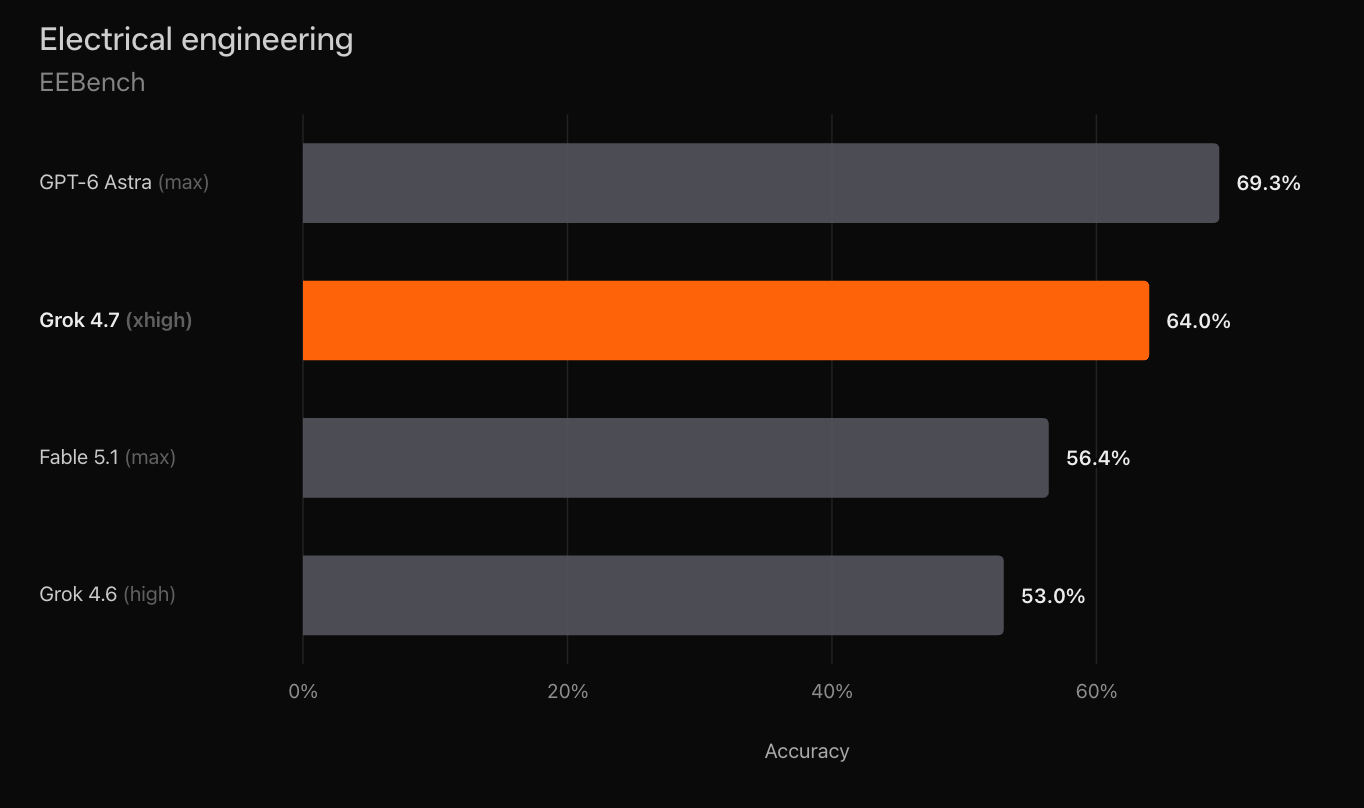
전자공학 분야 EEBench 테스트에서 Grok 4.7은 이전 세대에 비해 10%포인트 이상 증가한 64%의 점수를 달성했습니다. 많은 양의 전문 지식과 복잡한 작업 흐름을 포함하는 사무 작업의 경우 AA 서류 가방 테스트에서 모델 성능도 향상되었습니다.
법적 분석 측면에서 Grok 4.7은 Harvey Legal Agent Benchmark 테스트에서 19.6%의 점수를 얻었으며 이는 이전 세대 제품에 비해 더욱 향상된 수치입니다. 의학적 추론 분야에서도 HealthBench Professional 점수가 48.5%에서 56.7%로 향상되었습니다.
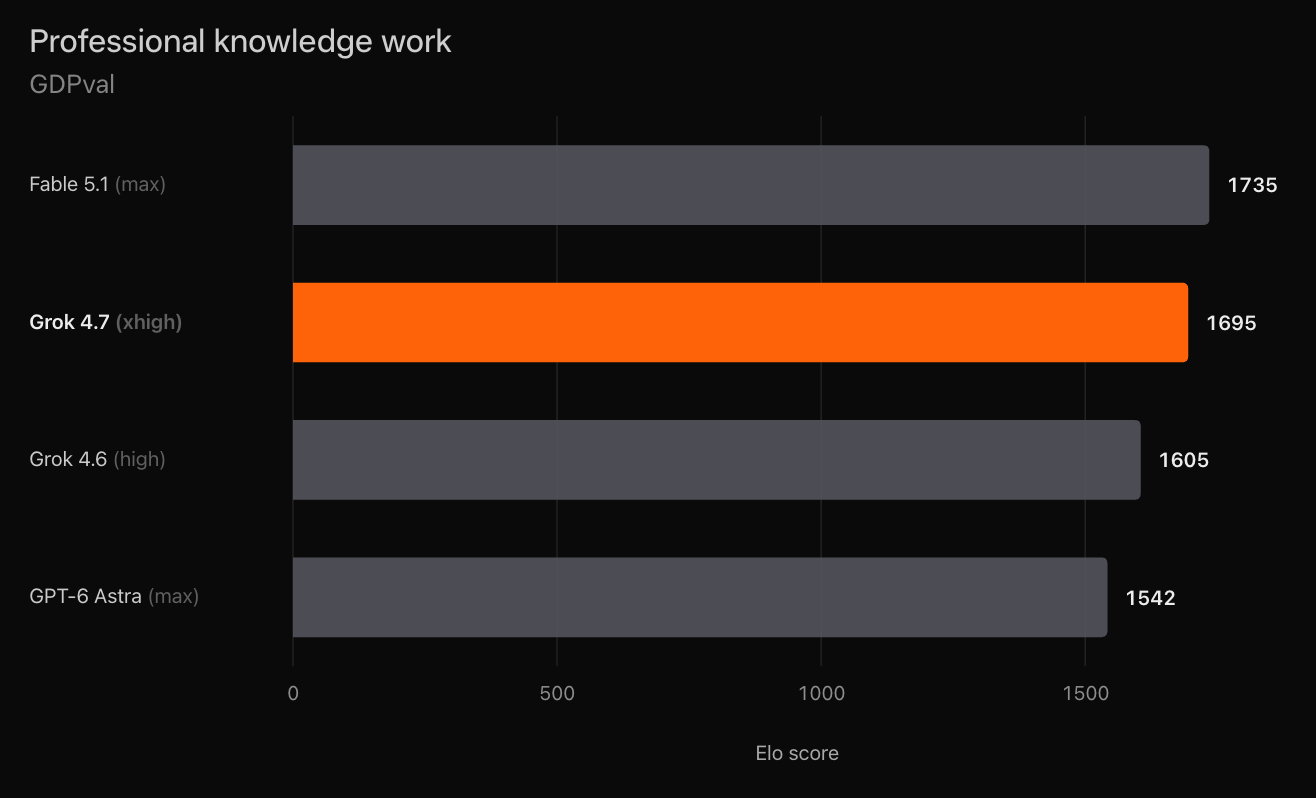
일반 지식 업무 분야에서 xAI는 특히 GDPval과 AA Briefcase의 두 가지 평가 결과를 강조했습니다. 회사는 이러한 테스트가 변호사, 간호사, 금융 분석가 등 전문가의 실제 업무 내용에 더 가깝다고 믿고 있으며, Grok 4.7은 이러한 시나리오에서 현재 최첨단 모델의 경쟁력 있는 수준에 도달했습니다.
가격은 이번 릴리스의 또 다른 중요한 판매 포인트입니다.
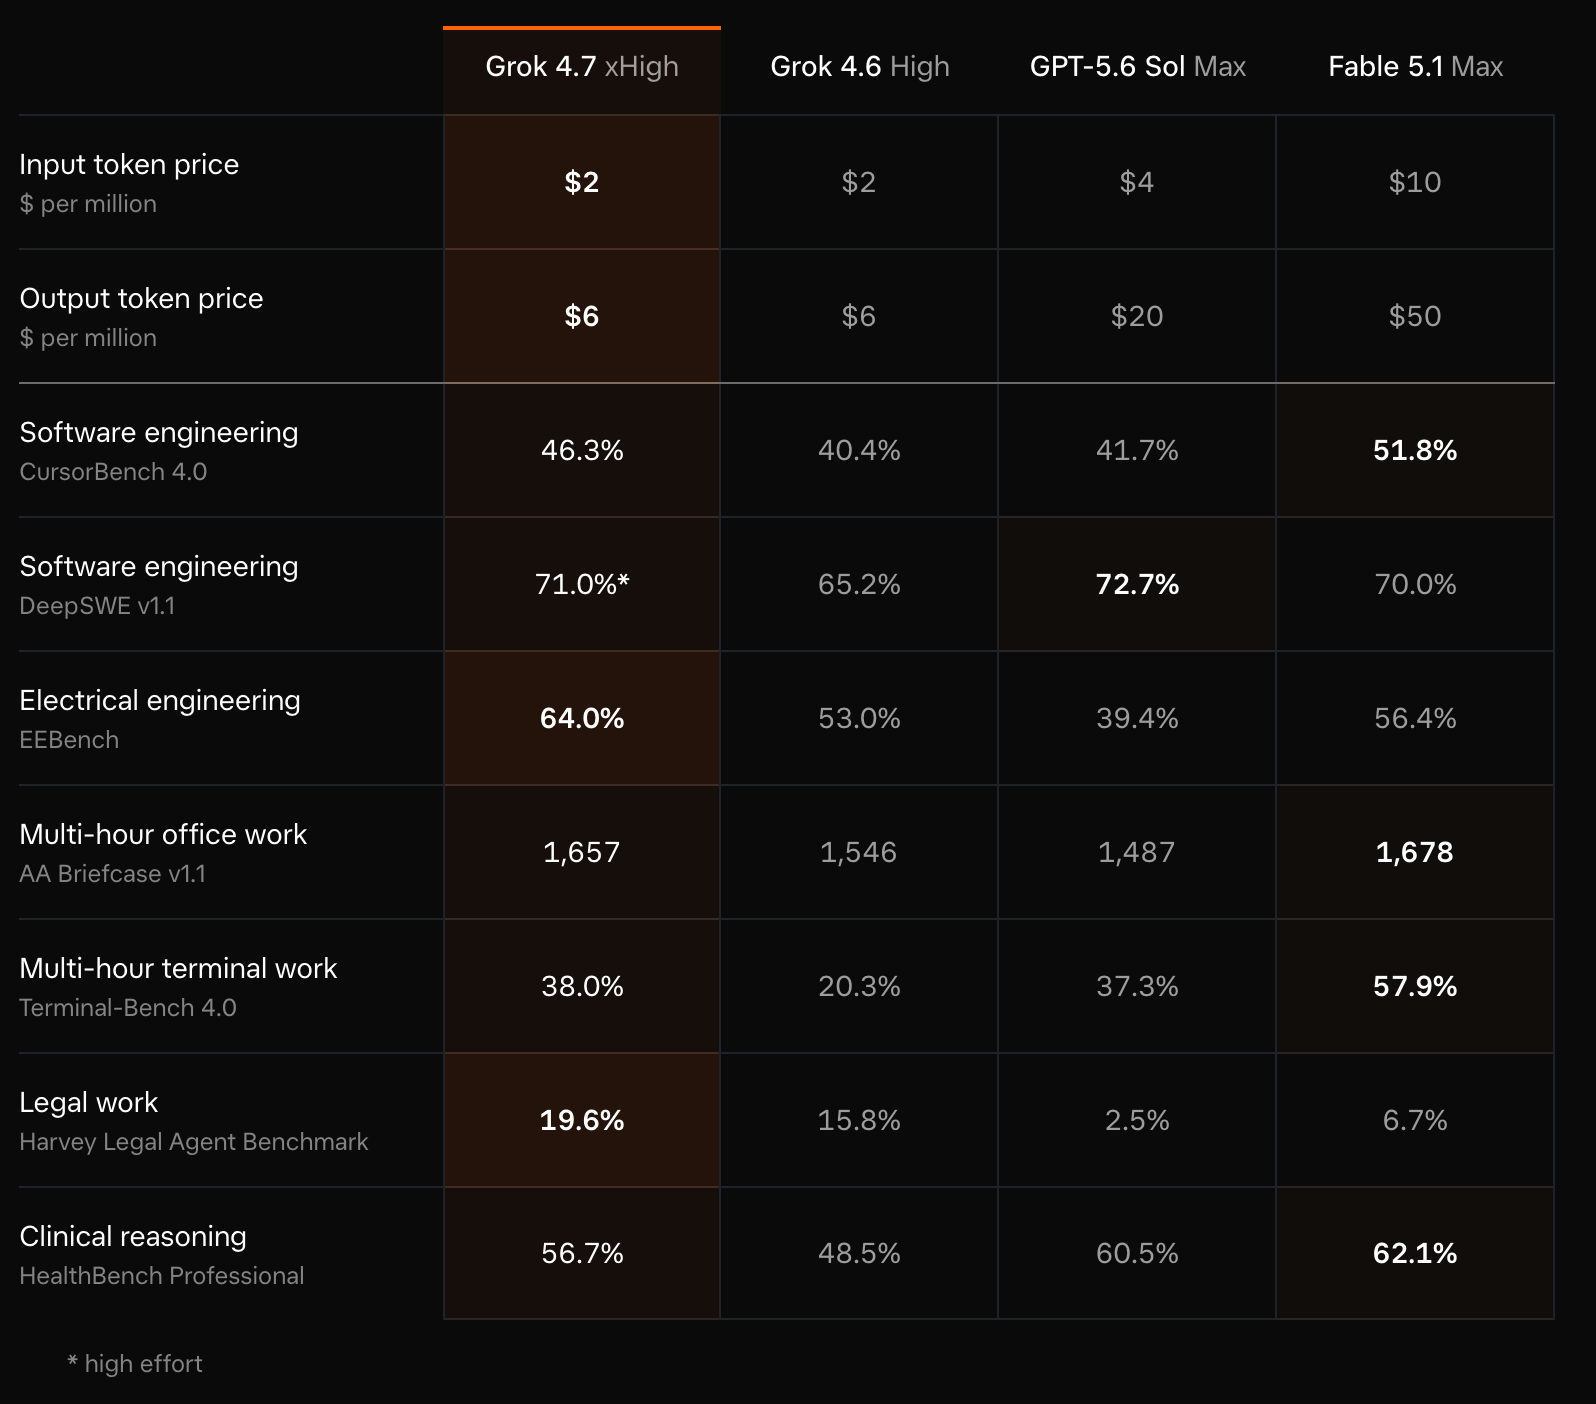
공식 데이터에 따르면 Grok 4.7의 입력 가격은 토큰 백만 개당 미화 2달러로 유지되고, 출력 가격은 Grok 4.6과 일치하는 토큰 백만 개당 미화 6달러입니다. 비용이 몇 배, 심지어는 10배 더 비싼 일부 최첨단 모델과 비교했을 때, xAI는 Grok 4.7이 더 저렴한 비용으로 비슷한 수준의 작업을 완료할 수 있다는 점을 강조합니다.
회사에서는 "동급 모델 대비 약 절반 가격으로 경쟁력 있는 성능을 제공하는" 솔루션이라고 설명하며, 비용 우위를 바탕으로 시장 점유율을 더욱 확대할 것으로 기대하고 있다.
보안 측면에서 xAI는 Grok 4.7이 새롭게 재구축된 보안 보호 시스템을 채택했다고 밝혔습니다. 내부 테스트 결과에 따르면, 새로운 모델은 위험한 요청 거부, 탈옥 공격 저항, 고위험 콘텐츠 식별 측면에서 Grok 시리즈 중 최고 수준에 도달했습니다.
특히 사이버 보안 및 생물 보안과 같은 민감한 영역에서 모델은 위험하거나 악의적인 사용을 거부하면서 합법적인 방어 작업을 처리하는 데 도움이 되도록 설계되었습니다. 공식 데이터에 따르면 Grok 4.7은 일부 네트워크 보안 위험 테스트 및 생물보안 평가에서 최고의 성능을 달성했습니다.
현재 Grok 4.7은 API와 Grok 플랫폼을 통해 사용자에게 공개되었습니다. 개발자는 프로그래밍, 지식 Q&A, 문서 작성 및 지능형 에이전트 애플리케이션 개발을 위해 이 모델을 호출할 수 있습니다.
Grok 4.7의 공식 출시로 xAI는 제품 반복 속도를 더욱 가속화했습니다. 올해 7월 Grok 4.5 출시부터 8월 Grok 4.6 출시, 그리고 이제 Grok 4.7 출시까지 xAI는 3개월도 안 되어 세 가지 주요 업그레이드를 완료했습니다. 경쟁이 치열한 인공 지능 시장을 위해 Grok 4.7은 정기적인 업데이트일 뿐만 아니라 더 빠른 반복, 저렴한 가격 및 더 강력한 작업 기능을 통해 업계 리더에게 도전하려는 xAI의 전략적 의도를 보여줍니다.
댓글