요약:
오늘 아침 SpaceXAI의 가장 강력한 모델인 Grok 4.7이 도착했습니다. 릴리스 페이지 시작 부분에는 단 하나의 매우 "공격적인" 포지셔닝이 있습니다. 프로그래밍 및 지식 작업을 위한 가장 강력한 모델로, 동급 모델보다 두 배 빠르고 가격은 절반에 불과합니다.
이번 업그레이드는 벤치마크에서 끝나지 않습니다. Grok 4.7은 더 큰 기본 모델로 전환하고 장기 작업, 자체 검토 및 장기 컨텍스트 관리 기능을 강화하며 문서, 프레젠테이션, 법률, 의료 및 엔지니어링 및 기타 전문 작업을 주요 테스트에 포함합니다. 그것이 목표로 하는 시나리오는 매우 명확합니다. 모델이 몇 시간 동안 지속되는 작업에서 우회를 피하고 직접 사용할 수 있는 결과를 제공하도록 허용하는 것입니다.
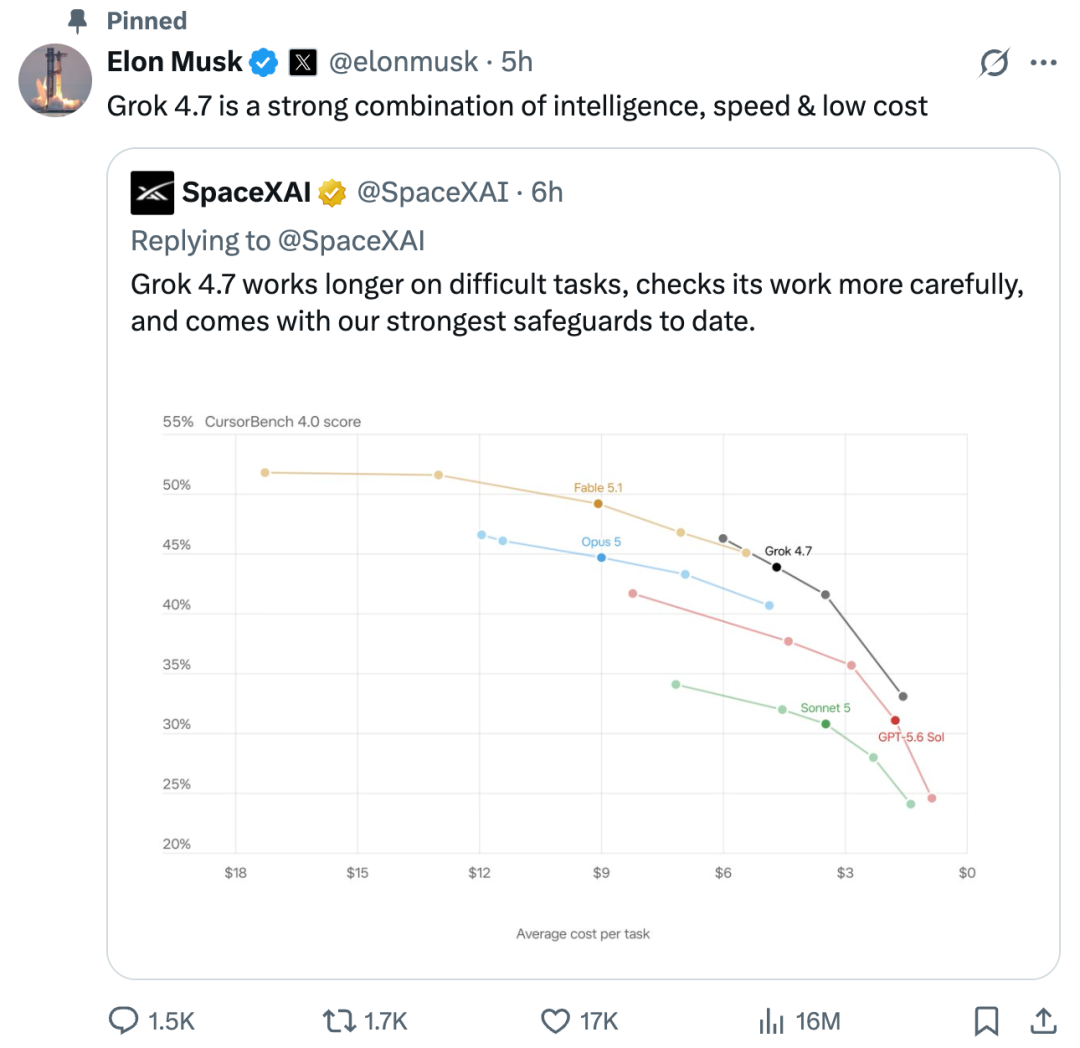
Musk는 "Grok 4.7은 지능 수준, 작동 속도 및 비용 간에 매우 경쟁력 있는 균형을 달성했습니다."라고 트윗했습니다.
장거리 임무가 이 세대 모델의 주요 전쟁터가 되었습니다
Grok 4.7은 Grok 4.6보다 더 큰 기본 모델을 사용합니다. 훈련 단계에서는 강화 학습 기간이 연장되고 작업 조합이 더욱 어려워지며 더 많은 샘플을 완료하는 데 몇 시간이 걸립니다. SpaceXAI는 새로운 모델이 자체 작업을 검사하고 긴 컨텍스트를 관리하는 능력을 향상시켰다고 말했습니다.
이러한 유형의 개선은 현재 프로그래밍 중인 지능형 에이전트의 가장 어려운 문제에 직접적으로 해당합니다. 짧은 코드 생성에는 부분적인 판단만 필요한 경우가 많지만 실제로 복잡한 소프트웨어 작업에는 창고 읽기, 요구 사항 해체, 여러 파일 수정, 테스트 실행 및 반복적인 오류 수정이 포함됩니다. 모델이 목표를 유지하고 긴 실행 체인에서 오류를 감지할 수 있는지 여부는 한 번에 아름다운 코드를 작성하는 것보다 더 중요한 경우가 많습니다.
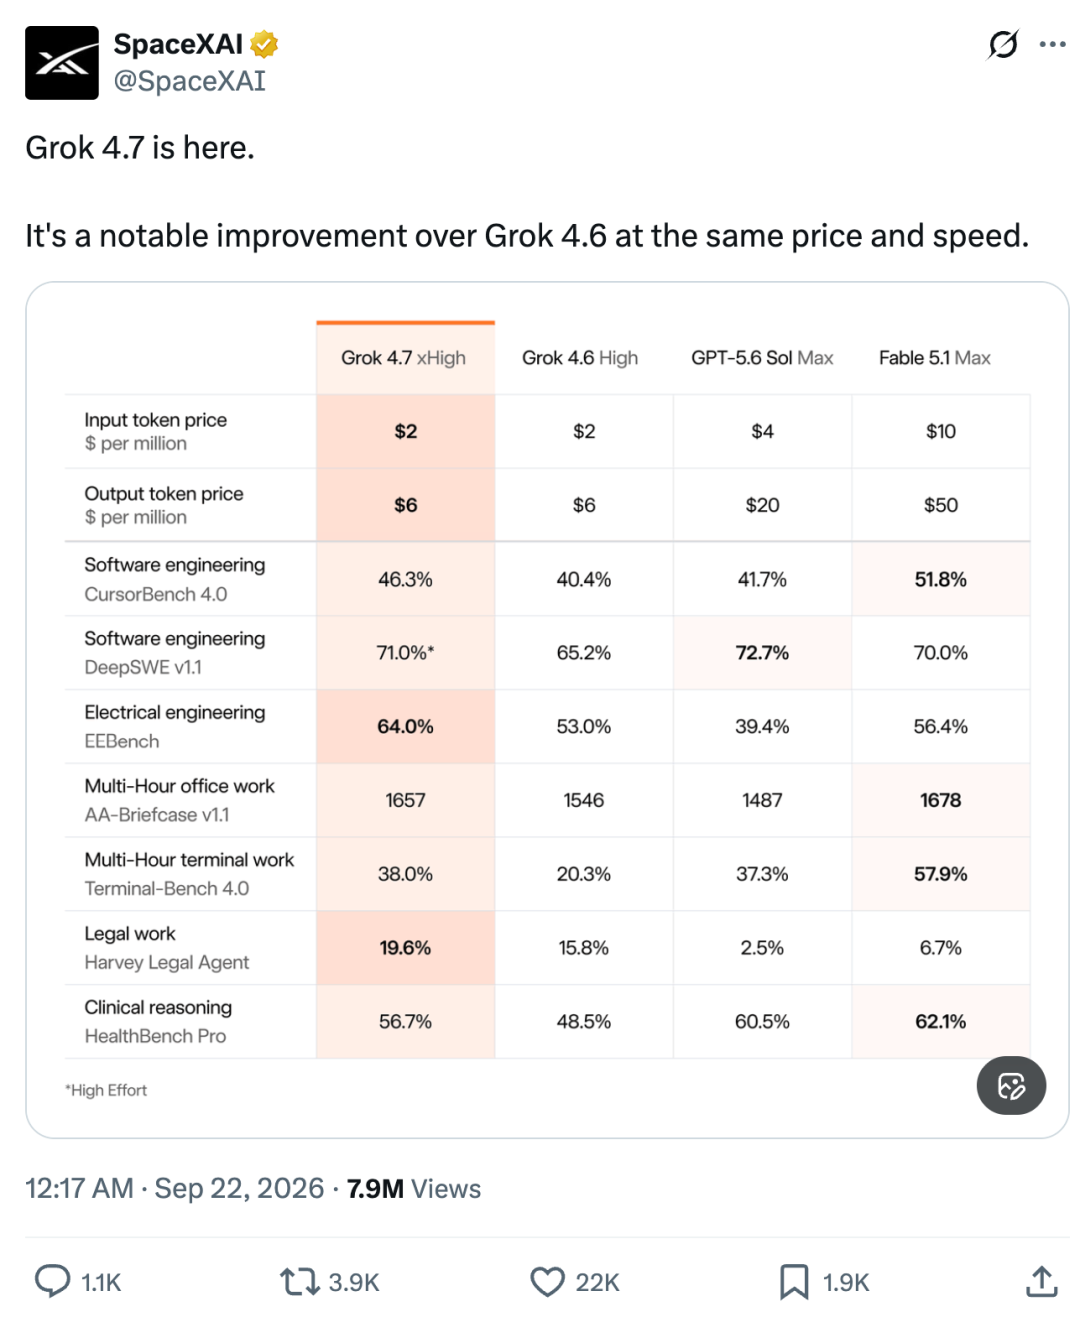
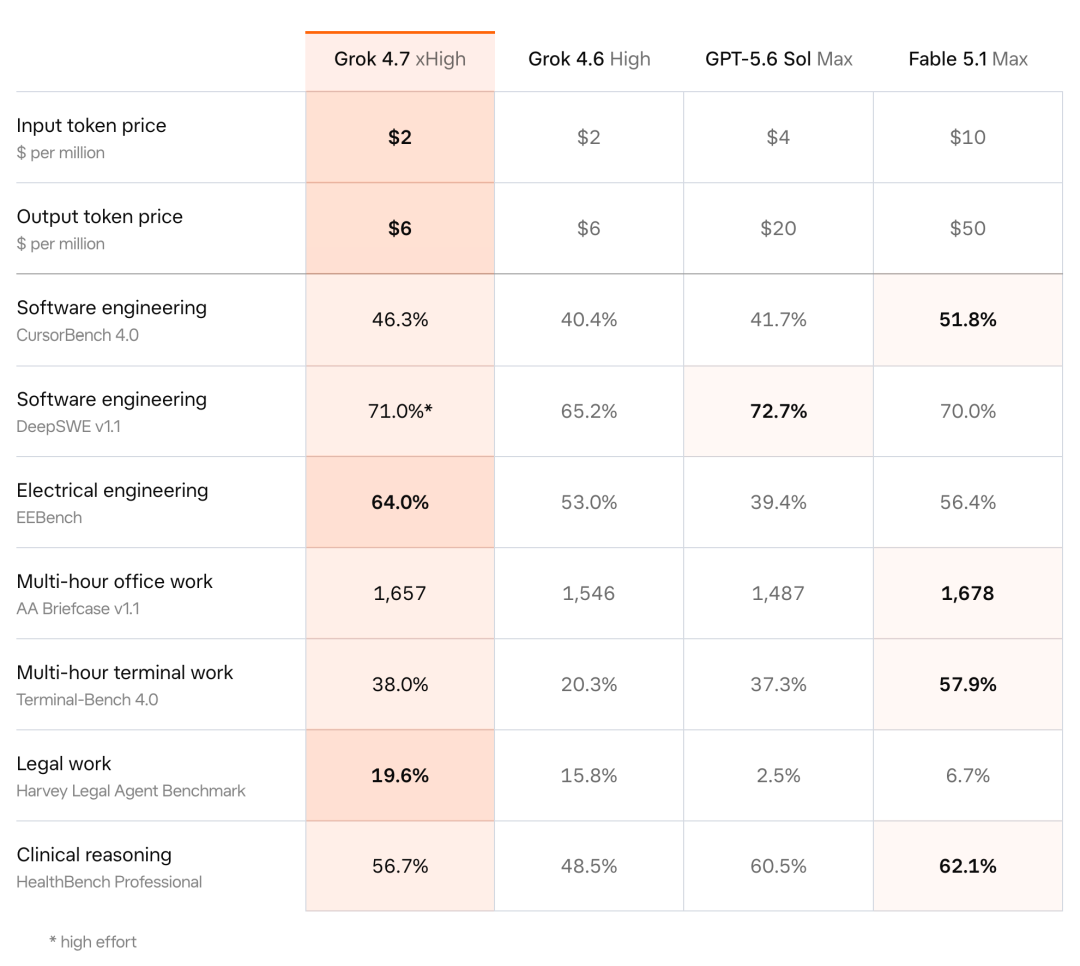
CursorBench 4.0은 특히 장기 코딩 작업을 검사합니다. 공식 자료에서는 그록 4.7이 46.3%, 그록 4.6이 40.4%로 5.9%포인트 증가했다. DeepSWE v1.1에서 Grok 4.7의 높은 추론 강도 점수는 71.0%였습니다. 터미널-벤치 4.0은 이전 세대 20.3%에서 38.0%로 증가했다.
이에 따라 Grok 4.7은 CursorBench 4.0의 최첨단 가격 및 성능 모델이라고 불립니다.
또한 모델은 Grok Bot이 실행되는 프레임워크를 기본적으로 이해하도록 학습되었습니다. 공식적으로 이러한 조정은 대화 작업 및 일반 지식 작업의 성능을 향상시킵니다. 즉, Grok 4.7의 업그레이드 초점은 단일 답변에서 모델, 도구 및 실행 환경 간의 지속적인 협업으로 확장되었습니다.
코드 작성부터 완전한 지식 작업까지
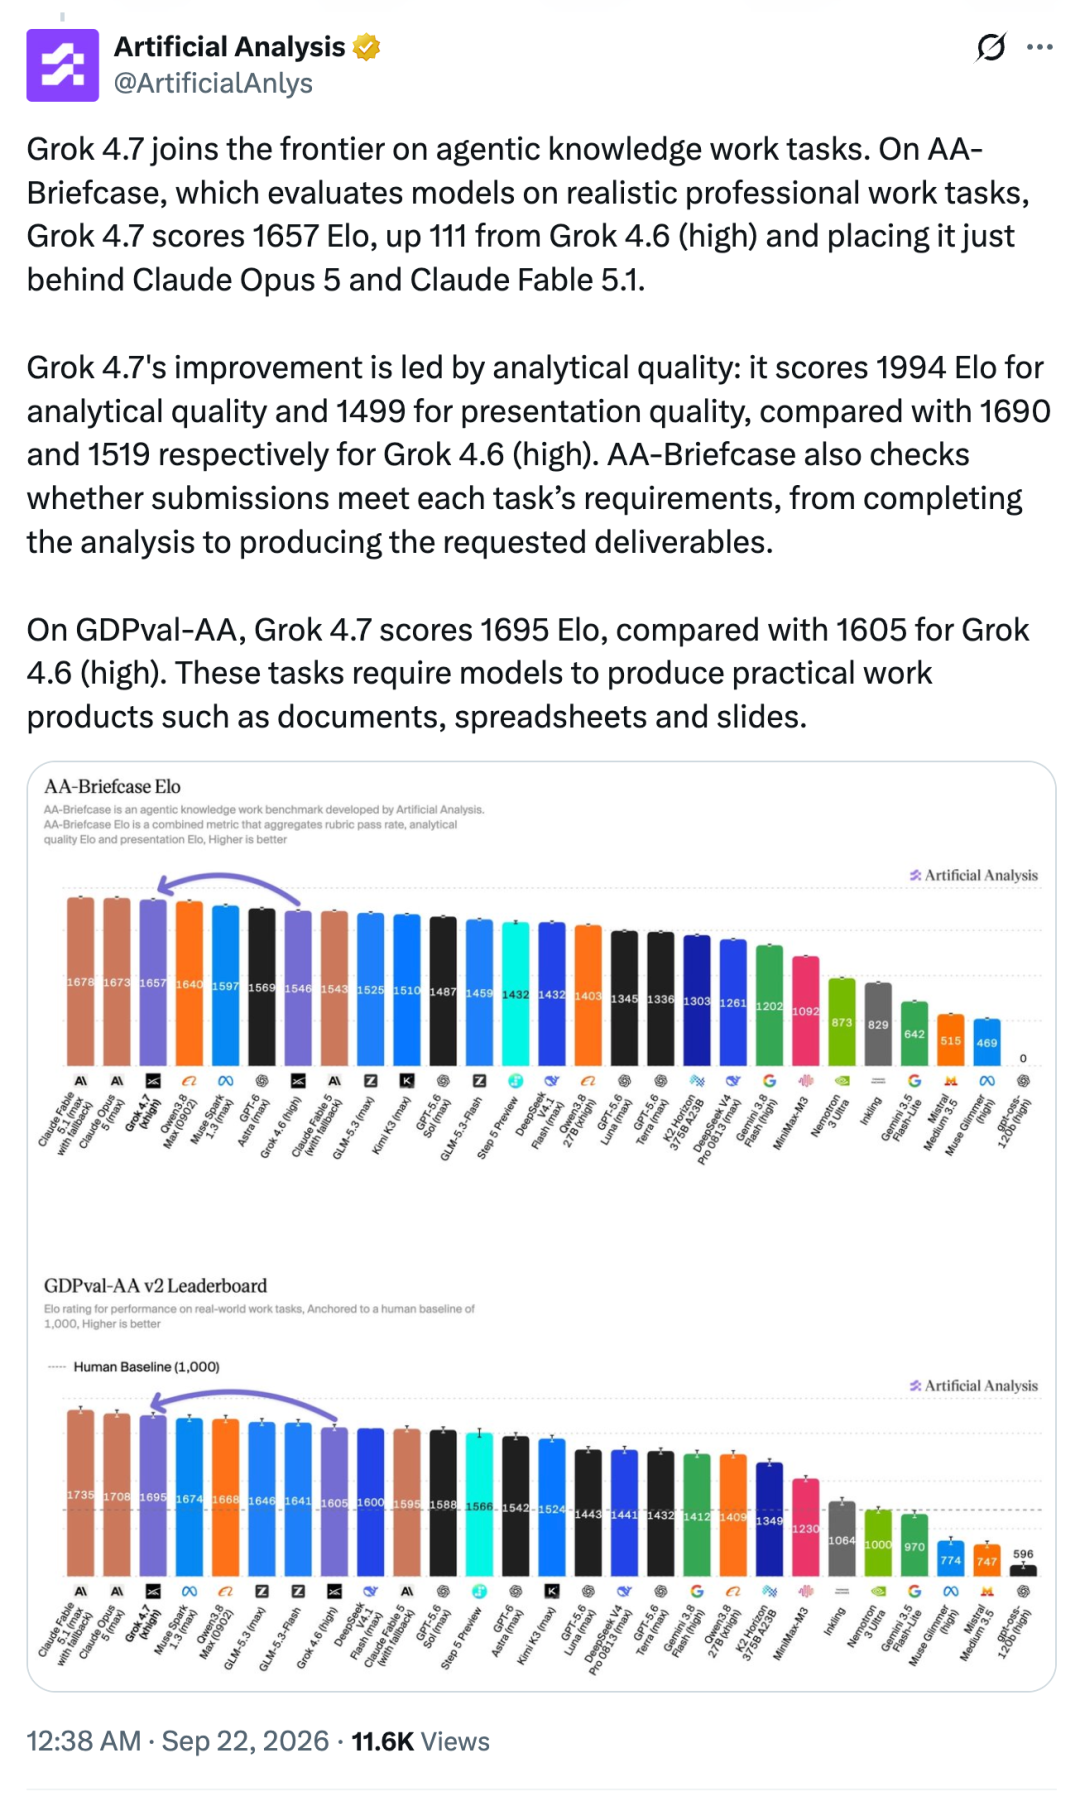
프로그래밍은 여전히 Grok 4.7에서 가장 눈길을 끄는 레이블이지만 SpaceXAI가 제공하는 평가 범위는 훨씬 더 넓습니다. AA Briefcase 및 GDPval은 변호사, 간호사, 재무 분석가 등의 직위에서 일반적인 작업은 물론 문서 및 프레젠테이션 제작을 포함하여 전문가가 매일 완료하는 다단계 작업에 중점을 둡니다.
AA 서류 가방 v1.1에서 Grok 4.7은 1657점을 얻었으며 이는 Grok 4.6의 1546점보다 높습니다. GDPval Elo 점수는 1605에서 1695로 증가했습니다. 공식 차트에서는 Fable 5.1의 GDPval 1735점에 가깝고 GPT-6 Astra의 1542점보다 높습니다. SpaceXAI는 Grok 4.7이 두 테스트 모두에서 이전 세대보다 성능이 뛰어나며 전체적으로 다른 첨단 모델과 동등한 성능을 발휘한다고 결론지었습니다.
전문 분야의 승진도 다방면에서 이루어집니다. EEBench 점수는 53.0%에서 64.0%로 증가했고, Harvey Legal Agent Benchmark는 15.8%에서 19.6%로 증가했으며, HealthBench Professional은 48.5%에서 56.7%로 증가했습니다. 이러한 결과는 SpaceXAI가 게시한 내부 비교표에서 나온 것입니다. 이 표는 이전 세대 모델과 새로운 세대 모델 간의 변경 사항을 설명할 수 있습니다. 모델 간 비교는 여전히 추론 강도, 도구 구성 및 테스트 환경의 영향을 받습니다.
이러한 결과는 분명한 추세를 보여줍니다. 최첨단 모델 경쟁이 '전체 작업 완료' 단계에 진입하고 있다는 것입니다.
모델은 작업을 이해하고, 도구를 호출하고, 파일을 생성하고, 자체적으로 검토해야 합니다. 단일 질문 및 답변 기능은 그 일부일 뿐입니다. Grok 4.7은 교육 작업 기간을 연장하고 자체 검증을 강화합니다. 이는 바로 이러한 유형의 워크플로를 보완하는 것입니다.
안전성과 가격
Grok 4.7은 향상된 기능 외에도 새로운 보안 보호 시스템을 활성화했습니다. SpaceXAI는 이 모델이 응답 거부 및 탈옥 저항 측면에서 가장 강력한 성능을 테스트한 모델이라고 밝혔습니다.
생물보안 테스트 측면에서 Grok 4.7은 62.4%의 점수로 LatchBio 벤치마크에서 1위를 차지했습니다. 사이버 보안 테스트 HackerBench v0.3은 주로 위험도가 높고 악의적인 작업을 다룹니다. 공식 데이터에 따르면 이 모델은 고위험 이중 용도 팁의 3.3%만 공개하며, 실수로 일반 보안 연구 요청을 차단하는 경우는 거의 없습니다.
SpaceXAI는 또한 방어 연구를 위해 제한된 수의 사이버 보안 파트너에게 초대 전용 레드팀 기능을 개방하기 시작했습니다. 현재 이 레드팀 기능은 처음에는 통제된 협업으로 사용할 수 있습니다.
표준 버전은 원래 가격으로 유지되며 빠른 버전의 속도는 두 배로 향상됩니다.
Grok 4.7은 Cursor 및 Grok Build에서 출시되었으며 Grok API, 타사 프로그래밍 프레임워크, 모델 라우팅 서비스 및 클라우드 플랫폼을 통해 제공됩니다. 표준 버전은 Grok 4.6과 일치하여 입력 토큰 백만 개당 2달러, 출력 토큰 백만 개당 6달러부터 시작합니다.
가격 전략으로 인해 이번 업그레이드가 더욱 효과적입니다. 개발자는 업그레이드를 위해 추가 표준 버전 토큰 비용을 지불할 필요가 없지만 보다 강력한 장기 작업 수행, 자체 검토 기능 및 전문적인 작업 결과를 얻을 수 있습니다.
프로그래밍 에이전트와 지식 작업 제품의 경우 각 모델 호출의 단가는 물론 중요합니다. 작업을 완료하는 데 필요한 시도 횟수와 재작업 횟수에 따라 실제 비용이 결정됩니다.
마지막으로 이번 업그레이드를 요약해 보세요.
교육 방법부터 평가 조합까지 Grok 4.7은 모두 오랫동안 작업을 수행하고 복잡한 작업을 완료한다는 동일한 내용을 강화합니다. 프로그래밍은 최초의 성숙한 진입점일 뿐입니다. 문서화, 프레젠테이션, 법적 분석, 임상 추론 및 엔지니어링 작업이 동일한 기능 세트에 포함되었습니다.
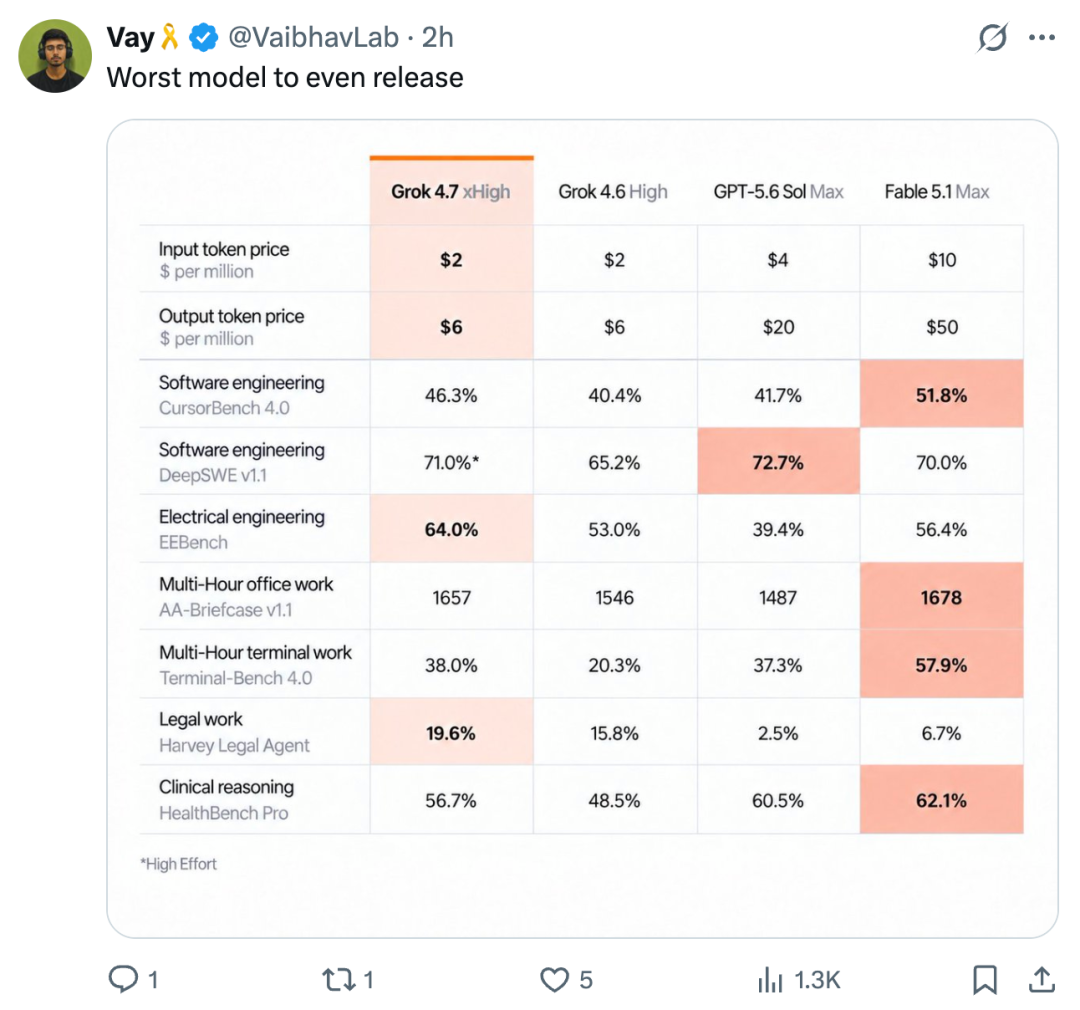
하지만 네티즌들은 별로 구매하지 않는 것 같습니다. "이 모델은 실제로 출시할 엄두가 나네요. 출시하면 안되는게 너무 안타깝습니다." 이번 Grok 4.7의 셀링 포인트는 경쟁 제품을 완전히 무너뜨리는 것이 아니라는 점을 정중하게 말씀드릴 수 있습니다. 개별 전문 작업에서 상당히 근접하고 선도적인 성능을 제공하는 대가로 일부 주력 모델보다 훨씬 낮은 API 비용을 사용합니다.
참조 링크:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
댓글