요약:
NVIDIA는 HBM4 고대역폭 메모리 대역폭 및 NVLink 고속 상호 연결 대역폭을 포함하여 차세대 Vera Rubin 인공 지능 컴퓨팅 플랫폼의 일부 하드웨어 사양을 조정했습니다. 기존에 발표되거나 유포된 지표와 비교하면 새로운 사양은 낮아졌지만 수평 확장 네트워크 대역폭은 늘어났다. 이러한 변화는 Nvidia가 실제 대량 생산을 기반으로 칩 성능, 공급 능력 및 시스템 비용의 균형을 재조정하고 있음을 의미할 수 있습니다.
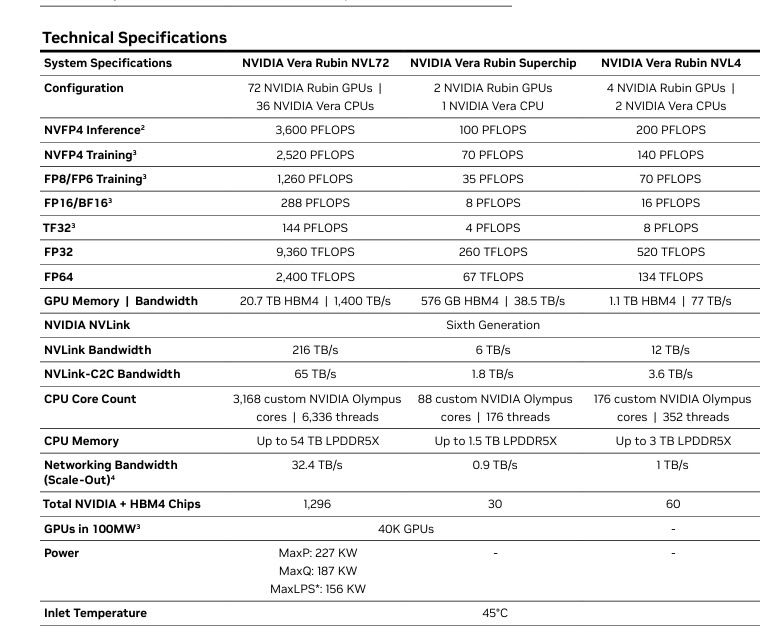
현재 NVIDIA가 발표한 Vera Rubin 플랫폼 사양에 따르면 Rubin GPU에는 288GB HBM4 메모리와 19.2TB/s의 메모리 대역폭이 탑재됩니다. 이전에 NVIDIA의 기술 데이터에서는 최대 메모리 대역폭 표시기가 22TB/s였습니다. 두 가지와 비교하면 현재 공시된 가치는 약 12.7% 정도 낮다. Nvidia는 이전에 "최대 도달 가능" 측정 기준을 사용했다는 점을 기억하는 것이 중요합니다. 따라서 이는 사양 번호의 변경 사항을 반영하며 반드시 모든 제품이 실제 성능에서 동일한 저하를 경험했다는 의미는 아닙니다.
HBM4는 더 넓은 메모리 인터페이스를 사용하여 인공 지능 모델 훈련 및 추론을 위한 더 높은 데이터 처리량 기능을 제공하는 차세대 고대역폭 메모리 기술입니다. 모델의 크기가 계속해서 확장됨에 따라 GPU에는 더 강력한 컴퓨팅 성능이 필요할 뿐만 아니라, 대량의 모델 매개변수와 중간 데이터를 지속적으로 획득해야 합니다. 메모리 대역폭이 부족하면 컴퓨팅 장치의 이론적인 컴퓨팅 파워가 아무리 높아도 데이터 대기로 인해 성능을 제대로 발휘하지 못할 수 있습니다.
이전에 Rubin 플랫폼이 추구했던 높은 메모리 대역폭은 HBM4 공급망에 더 높은 기술 요구 사항을 가져왔습니다. 비디오 메모리 제조업체는 더 높은 데이터 전송 속도에서 전력 소비, 열 방출, 신호 무결성 및 장기적인 신뢰성 요구 사항을 충족해야 합니다. 대역폭 사양이 높을수록 설계 검증 및 대량 생산 프로세스에서 일반적으로 직면하는 문제가 더 커집니다.
NVIDIA가 메모리 대역폭 요구 사항을 낮추면 제품 표준을 충족하는 HBM4 칩의 범위가 확대될 수 있으며 공급업체도 적격 제품의 출력 비율을 높일 수 있는 기회를 갖게 됩니다. 이는 비디오 메모리 제조업체가 전체 제품 세트를 재설계해야 한다는 의미는 아니지만, 이전의 최고 성능 목표에 도달할 수는 없지만 여전히 새로운 요구 사항을 충족하는 일부 제품이 공급 시스템에 들어가도록 허용하여 전반적인 공급 능력을 향상시킬 수 있습니다.
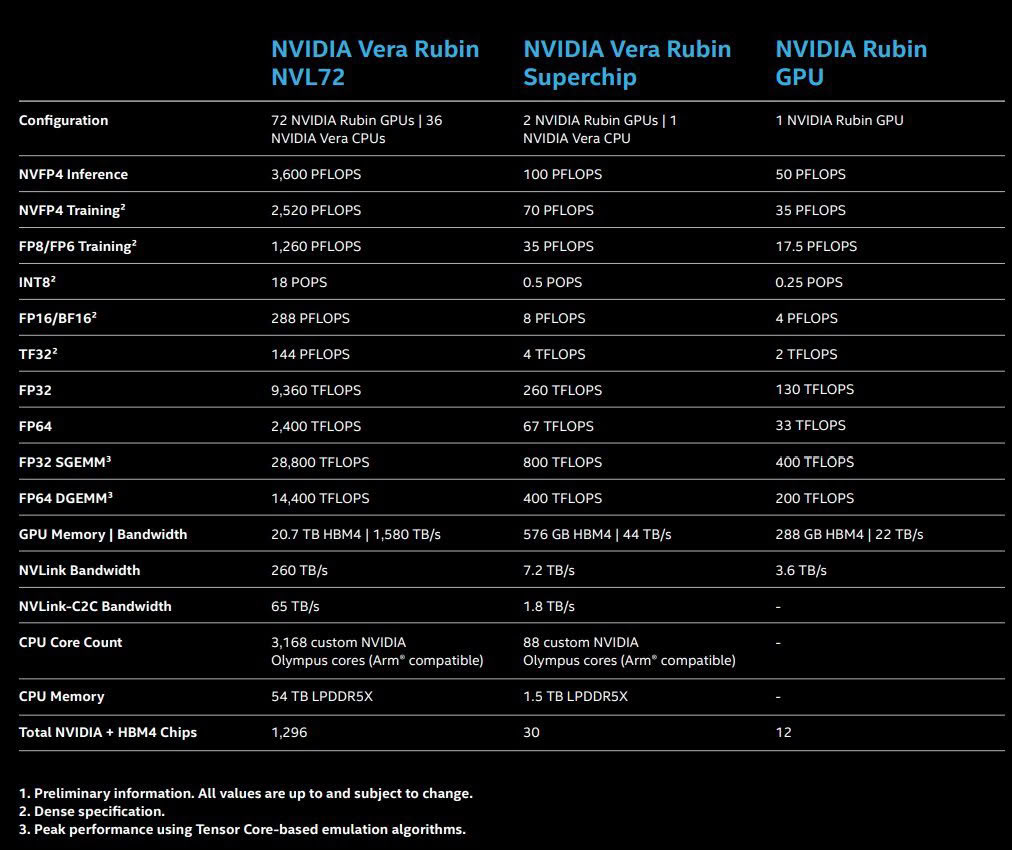
메모리 대역폭 외에도 Nvidia는 Vera Rubin 슈퍼 칩의 NVLink 상호 연결 사양도 조정했습니다. 현재 제품 정보에 따르면 Vera Rubin 슈퍼 칩의 NVLink 대역폭은 이전 7.2TB/s에서 6TB/s로 조정되어 약 16.7% 감소했습니다. NVLink는 GPU 간의 고속 통신을 위한 NVIDIA의 상호 연결 기술입니다. 다중 GPU 시스템에서 데이터 교환, 모델 병렬 훈련 및 복잡한 인공 지능 추론 작업에서 중요한 역할을 합니다.
대규모 인공지능 클러스터에서는 기울기, 활성화 값, 기타 중간 데이터가 GPU 간에 자주 교환되어야 합니다. 다양한 컴퓨팅 장치 간의 통신은 전문적인 하이브리드 아키텍처를 갖춘 대형 모델의 경우 특히 중요합니다. 따라서 NVLink 대역폭 표시기를 줄이면 일부 통신 집약적 작업의 성능에 영향을 미칠 수 있지만 최종 영향은 여전히 모델 아키텍처, 소프트웨어 예약 방법 및 실제 로드에 따라 달라집니다. 전체 컴퓨팅 전력 손실은 단순히 대역폭 감소 비율을 기준으로 계산할 수 없습니다.
동시에 Nvidia는 일부 확장 네트워크에 대한 대역폭 측정항목을 늘렸습니다. 기존 데이터에 따르면 베라 루빈 슈퍼칩의 수평 확장 네트워크 대역폭은 기존 0.8TB/s에서 0.9TB/s로 늘어났다. 이러한 유형의 네트워크는 주로 다양한 컴퓨팅 노드를 연결하는 데 사용되며, 이를 통해 데이터 센터는 다수의 GPU를 통합 컴퓨팅 클러스터로 구성할 수 있습니다. 네트워크 대역폭을 늘리면 특히 서버 전체에서 컴퓨팅 작업을 공동으로 완료해야 하는 경우 노드 간의 데이터 전송 기능을 향상시키는 데 도움이 될 수 있습니다.
이러한 하향 조정과 상향 조정은 인공 지능 컴퓨팅 플랫폼 설계의 상충 관계를 반영합니다. GPU 및 캐비닛 내부의 통신 기능은 중요하지만 클러스터 규모가 확장됨에 따라 노드 간 통신도 전체 성능을 제한하는 요소가 될 수 있습니다. Nvidia는 실제 애플리케이션 요구 사항을 기반으로 시스템 설계의 성능 예산을 재할당할 수 있습니다.
그러나 사양 변경 자체가 엔비디아가 비디오 메모리 부족을 확인했다는 것을 증명할 수도 없고, 지표를 낮추는 것이 생산량을 늘리는 것임을 증명할 수도 없습니다. 관련 설명은 아직 공급업체의 양산 진행 상황, 제품 인증 현황, 엔비디아가 공개한 후속 정보 등을 토대로 판단해야 한다.
HBM4 공급망의 경우 사양 조정으로 인해 공급업체 간의 경쟁 초점이 바뀔 수 있습니다. 이전에 제조업체는 더 높은 데이터 전송 속도를 위해 노력해야 했습니다. Nvidia가 대량 생산 제품의 대역폭 요구 사항을 줄이면 경쟁은 수율, 공급 규모, 전력 소비, 안정성 및 비용에 더욱 집중될 수 있습니다. 결과적으로 적격 제품을 대규모로 제공할 수 있는 공급업체는 더 많은 기회를 얻을 수 있습니다.
전체 플랫폼의 관점에서 Vera Rubin은 성능을 결정하기 위해 메모리 대역폭에만 의존하지 않습니다. GPU 컴퓨팅 성능, 비디오 메모리 용량, 칩 간 상호 연결, 네트워크 아키텍처 및 소프트웨어 최적화가 시스템 성능을 공동으로 결정합니다. Nvidia가 공식 발표한 Vera Rubin NVL72 캐비닛 구성에는 72개의 Rubin GPU가 포함되어 있으며 6세대 NVLink를 통해 여러 GPU를 연결하여 대규모 인공 지능 훈련 및 추론 작업을 지원합니다.
따라서 일부 하드웨어 지표가 초기 목표보다 낮더라도 Vera Rubin은 컴퓨팅 아키텍처, 비디오 메모리 용량 및 시스템 수준 최적화를 통해 여전히 더 높은 성능을 달성할 수 있습니다. 정말 주목해야 할 점은 엔비디아가 사양 조정 후 계획대로 출하량을 늘릴 수 있을지, 실제 모델 훈련과 추론 성능이 고객의 기대에 부응하는지 여부다.
댓글