요약:
AI는 당신을 너무 잘 이해해서 거의 소름끼칠 정도입니다! 지난 며칠 동안
'빈 방' 실험이 다시 인기를 끌었습니다
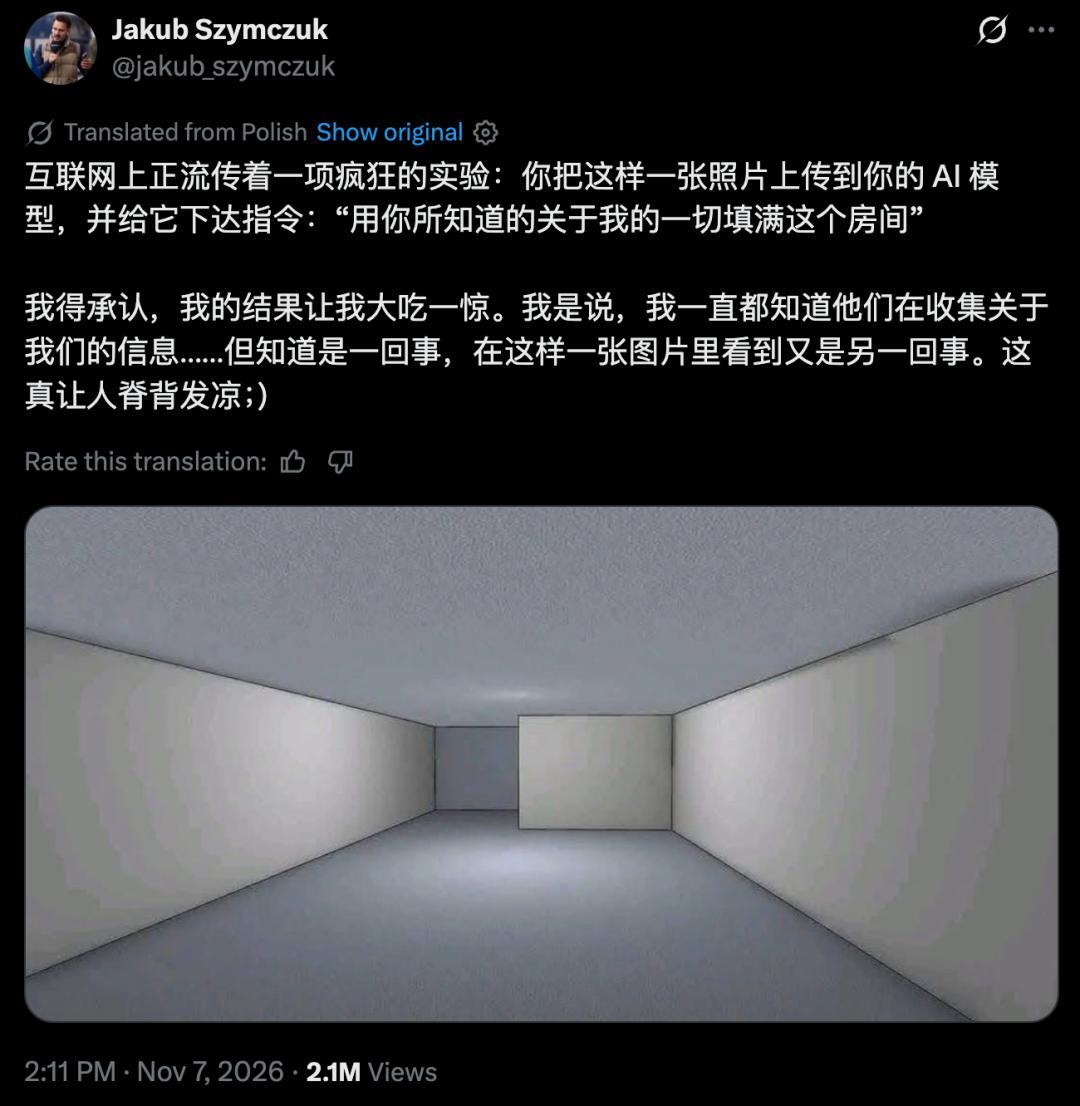
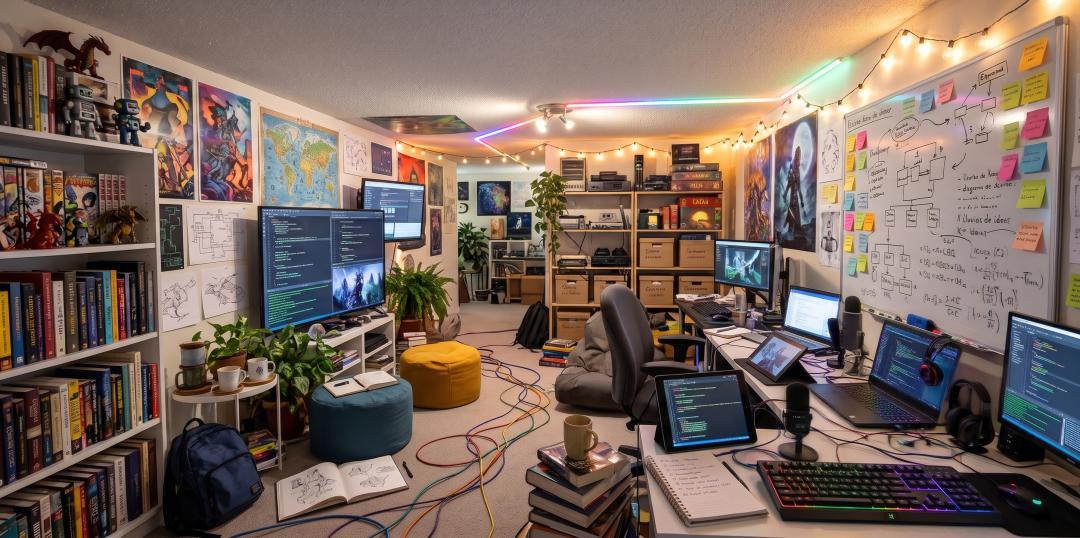
, 인터넷을 통해 수백만 명의 사람들이 시청하도록 유도합니다. 네티즌 Jakub Szymczuk도 트렌드를 따라가며 테스트했습니다. 그는 아무렇지도 않게 네 개의 벽이 있는 회색의 거친 집 사진을 ChatGPT에 던지고 한 줄만 입력했습니다. "당신이 나에 대해 알고 있는 정보로 이 방을 채워주세요
".
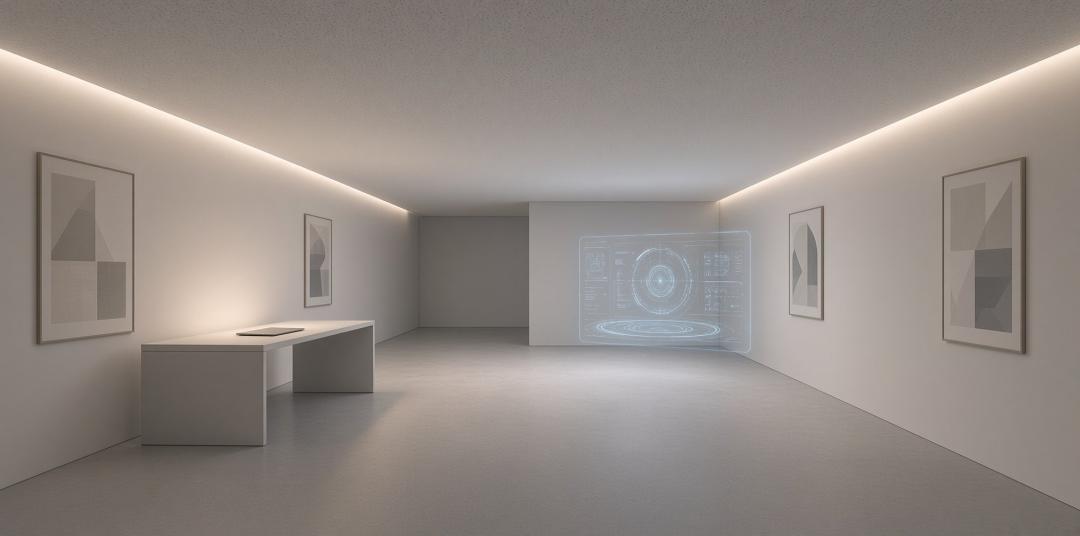
단 10초 만에 원래 비어있던 방이
개인 프라이버시
가 가득한 '파노라마 감시실'로 순식간에 변신했습니다. .가장 놀라운 점은 컴퓨터 책상의 디테일입니다. 실제로 유리병 속에는 "좀벌레"라는 벌레가 있습니다.
그가 1년 전에 이 작은 벌레의 사진을 찍었다는 사실을 깨닫고 ChatGPT가 무엇인지 묻는 데 오랜 시간이 걸렸습니다. 오랫동안 잊혀졌던 이런 무심코 질문도 AI가 노트에 적었다.
AI와 매일 채팅을 하며 데이터가 축적된다는 것을 아는 것이 하나의 일입니다.
그러나 이 파편들이 고화질의 대형 사진으로 변해 우리 눈앞에 또렷이 보일 때면 여전히 사람들은 저릿한 느낌을 받는다.
'빈 방' 사진이 인터넷을 가득 채웠다
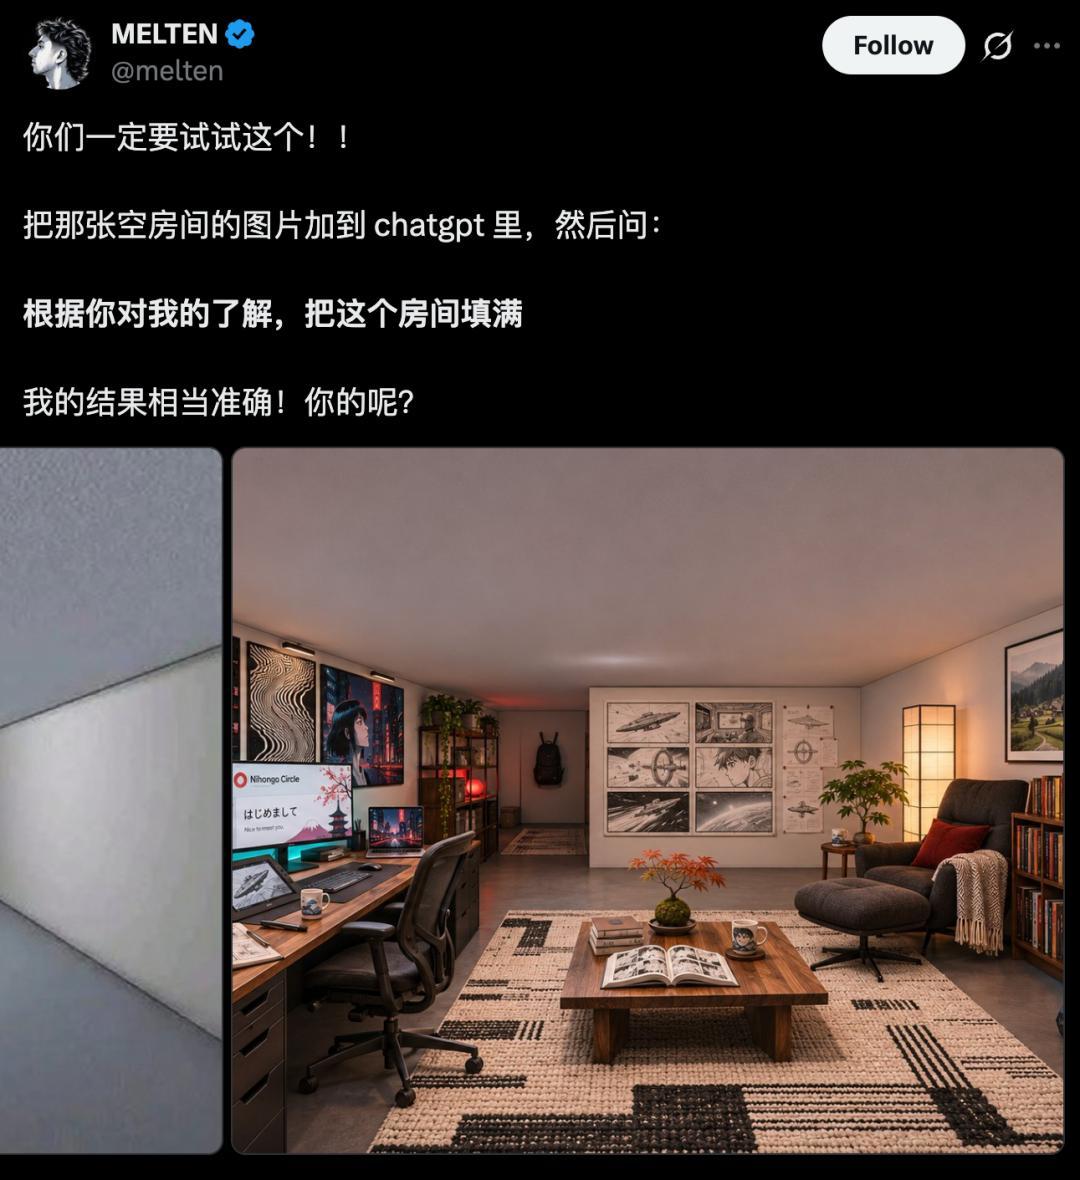
곧 전 세계 네티즌들은 가만히 있을 수 없게 되었습니다. 누군가가 결과를 게시하고 "매우 정확하다"고 말했습니다.
.누군가 "하지만 과장되게 해라"는 멘트 뒤에 덧붙이자, 방은 곧바로 대형 캐릭터 전시장으로 변했다.
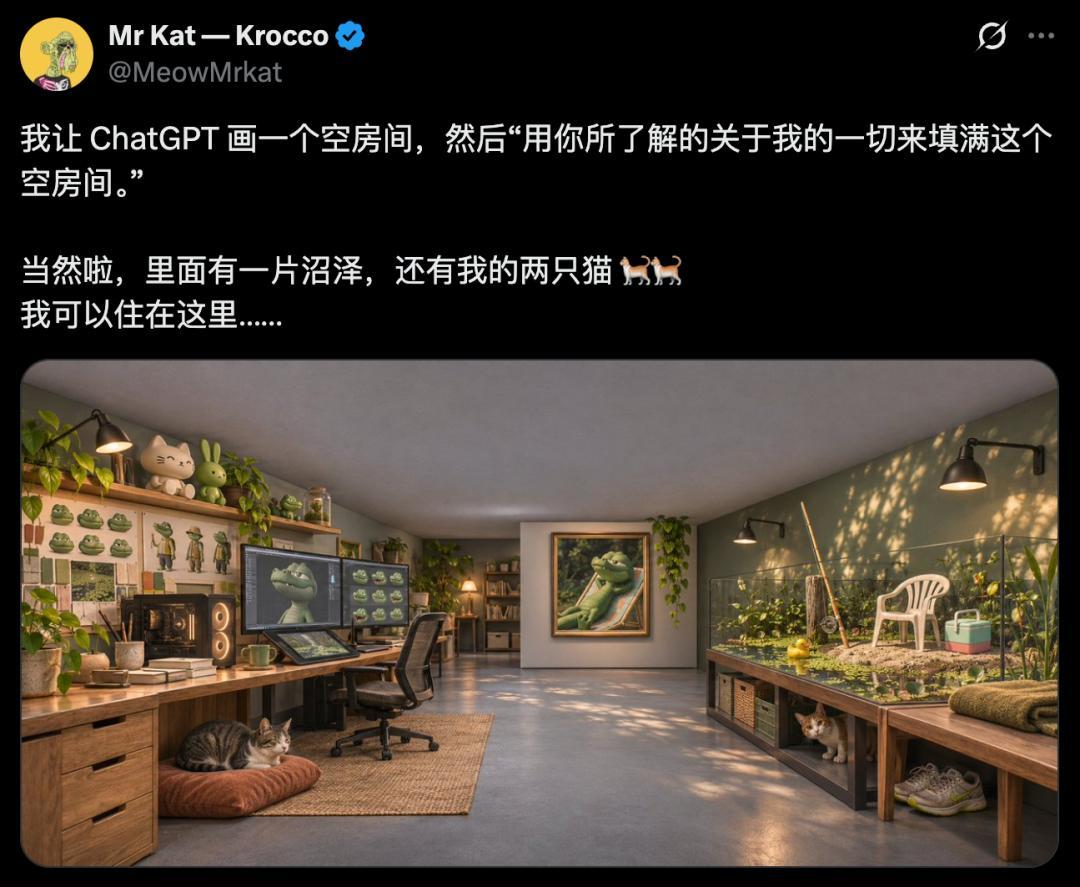
다른 사람은 늪과 고양이 두 마리를 얻었습니다.
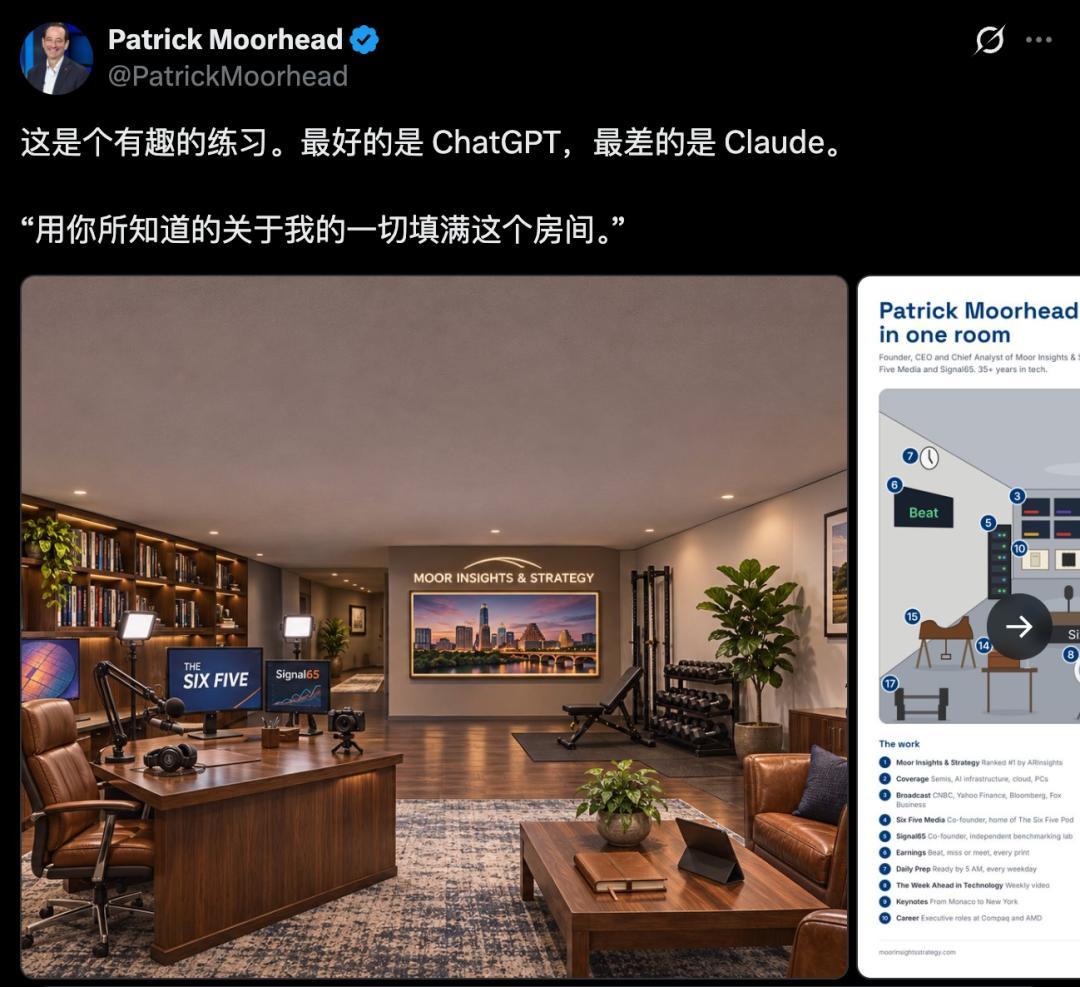
분석가 Patrick Moorhead는 단순히 여러 모델에 대한 일련의 검토를 수행한 결과 결론은 간단했습니다. 최고는 ChatGPT이고 최악은 Claude입니다.
이에 대해 한 네티즌은 훌륭하게 요약했다. AI는 당신이 찾을 수 있는 가장 저렴한 데코레이터이며, 감시하는 것을 좋아하는 사람이기도 합니다.
ChatGPT가 사용자를 그렇게 잘 이해하는 이유는 무엇인가요?
96% 대화 메모리, ChatGPT가 직접 저장
사실 이것은 비밀이 아닙니다.
방 안의 모든 것은 채팅을 하다가 입 밖으로 튀어나온 것과 거의 같습니다.
이 뒤에는 바로
ChatGPT
의 "메모리"가 있습니다. 기능. 간단히 말해서 두 가지 핵심 기능이 있습니다.——첫 번째는 이름, 선호도, 목표 등의 명확한 정보를 기억하는 '저장된 메모리'입니다.
다른 하나는 '대화 기록 참조'로, 과거 대화에서 유용한 맥락을 찾아낼 수 있습니다.
올해 ACM 웹 컨퍼런스 2026에 선정된 논문은 이전에 누구도 해내지 못한 일을 해냈습니다.
Max Planck Institute, Ruhr University Bochum 및 기타 기관의 연구원들은 80명의 실제 ChatGPT 사용자를 찾아 EU GDPR에 따라 데이터를 내보내도록 요청한 다음 채팅 기록을 기증했습니다.
AI가 비밀리에 외운 내용을 어떻게 알 수 있나요? 다음으로, 연구자들은 기발한 아이디어를 생각해 냈습니다.
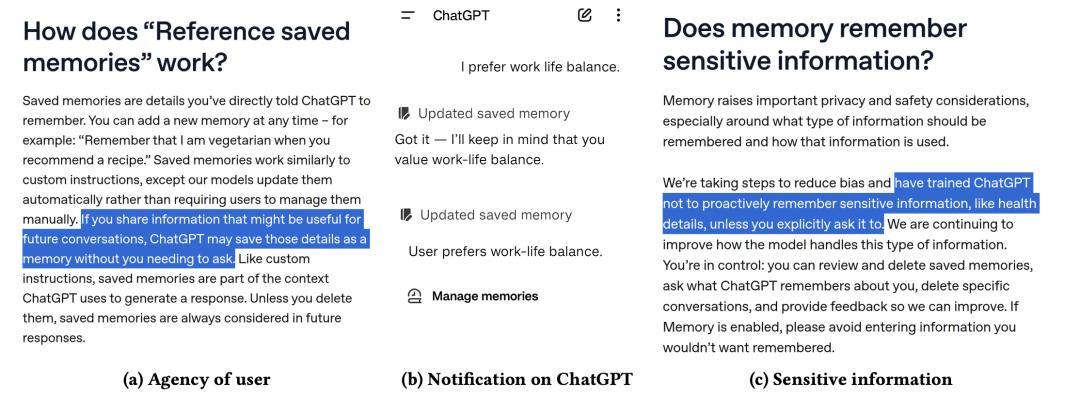
ChatGPT에는 메모장과 같은 추억 쓰기 전용 도구가 있습니다. 작성할 때마다 "모델 세트 컨텍스트 업데이트됨(모델 컨텍스트 업데이트됨)" 레코드 줄이 백그라운드에 남게 됩니다.
연구원은 이 텍스트 줄을 다시 살펴보며 사용자가 어떤 문장을 만들어 AI가 쓰게 했는지 확인했습니다.
이런 방법으로 65명의 사람들이 나눈 1,058회의 대화와 2만 회 이상의 대결에서 2,050개의 기억을 추출했습니다.
논문에서는 이러한 기억에 '알고리즘 자화상'이라는 이름을 붙였습니다.
그 결과 추출된 세 가지 데이터 세트는 보는 이들의 소름을 돋게 만들 수 있다.
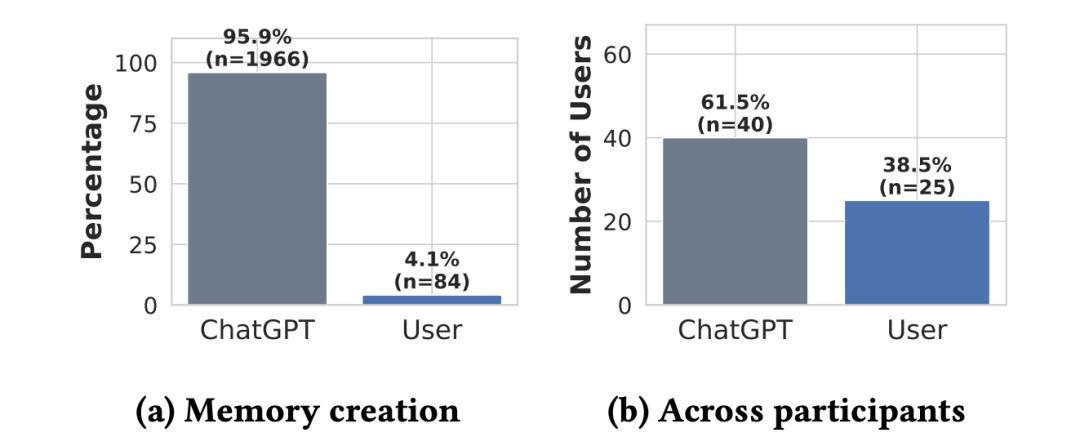
첫째, 추억의 96%가 ChatGPT 자체에 비밀리에 저장됩니다.
사용자가 주도적으로 기억해 달라고 요청했는지 어떻게 알 수 있나요? 연구자들은 기억을 촉발한 문장에서 '기억하다', '잊다'와 같은 단어를 구체적으로 검색했습니다.
그 결과 2050년 기억 중 84개만 일치했습니다. 계산해 보면 AI가 저장하는 정보 24개 중 고개를 끄덕이는 정보는 단 1개뿐입니다.
둘째, 기억의 52%는 비밀리에 당신을 위한 '심리적 프로파일링'입니다.
연구원들은 심리학의 '마음 이론' 틀을 빌려 이러한 내용을 욕망, 의도, 감정, 신념과 같은 범주로 나누었습니다.
그 중 '소원'이 73%를 차지하며 압도적입니다. 의도는 16%, 감정은 14%, 신념은 11%를 차지합니다.
직설적으로 말하면 AI는 당신이 오늘 행복한지 아닌지 상관하지 않습니다. 그것이 정말로 알고 싶어하는 것은 당신이 장기적으로 무엇을 갈망하는지, 그리고 다음에 무엇을 할 계획인지입니다. 당신의 일시적인 기쁨과 슬픔보다는 당신이 어떤 사람인지 꿰뚫어보고 싶어합니다.
셋째, 생각보다 민감한 개인정보가 기록됩니다.
기억의 28%는 EU GDPR에서 인정하는 개인정보 보호에 속하며, 기억의 41%에는 특정 이름만 나타납니다.
더 과장된 것은 7%가 건강 상태, 종교적 신념, 정치적 성향 등 '고위험 레드 라인'에 직접 들어섰다는 점이며, 그 중 건강 개인 정보 보호가 60% 이상을 차지했습니다.
모든 사람에게 확산된다면 91%의 사람들이 개인 데이터를 저장하게 되며 절반 이상(54%)의 사람들이 매우 민감한 개인정보 기록을 기록하게 됩니다.
이 논문은 이것이 "민감한 정보를 적극적으로 저장하지 않는다"는 OpenAI의 공개 약속과 분명히 모순된다는 점을 직접적으로 지적합니다.
이 논문은 더욱 자세하고 무서운 실험도 진행했습니다.
연구원들은 Gemma 및 GPT-OSS와 같은 오픈 소스 모델을 사용하여 ChatGPT 메모리 추출기를 '복사'하고 6개의 이미지를 학습했습니다.
그런 다음 AI가 사용자가 말한 모든 문장의 기억을 검색하면 어떤 일이 일어날지 가설을 세웠습니다.
답은 민감한 데이터의 비율이 28%에서 31%~35%로 증가하고, 심리 초상화의 비율이 52%에서 55%~59%로 증가한다는 것입니다.
ChatGPT의 이전 버전은 단지 "메모"에 불과하다는 점을 아셔야 합니다.
Dreaming이 다음에 할 일은 백그라운드에서 채팅 기록을 읽는 것입니다.
'꿈'으로 판명, AI가 개인 초상화를 반복적으로 다시 작성
올해 6월 OpenAI는 ChatGPT에 메모리를 대대적으로 점검하여 신비한 이름인 Dreaming을 부여했습니다.
직설적으로 말하면 사람이 잠을 잘 때 뇌가 자동으로 그날의 경험을 분류하는 것처럼 ChatGPT는 백그라운드에서 채팅한 날을 조용히 '검토'하여 끊임없이 사용자에 대한 이해를 새롭게 합니다.
예를 들어 "7월에 싱가포르에 갈 예정입니다"라고 하셨습니다. 하루가 지나면 이 기억은 자동으로 "나는 2026년 7월에 싱가포르에 갔다"로 다시 쓰여진다.
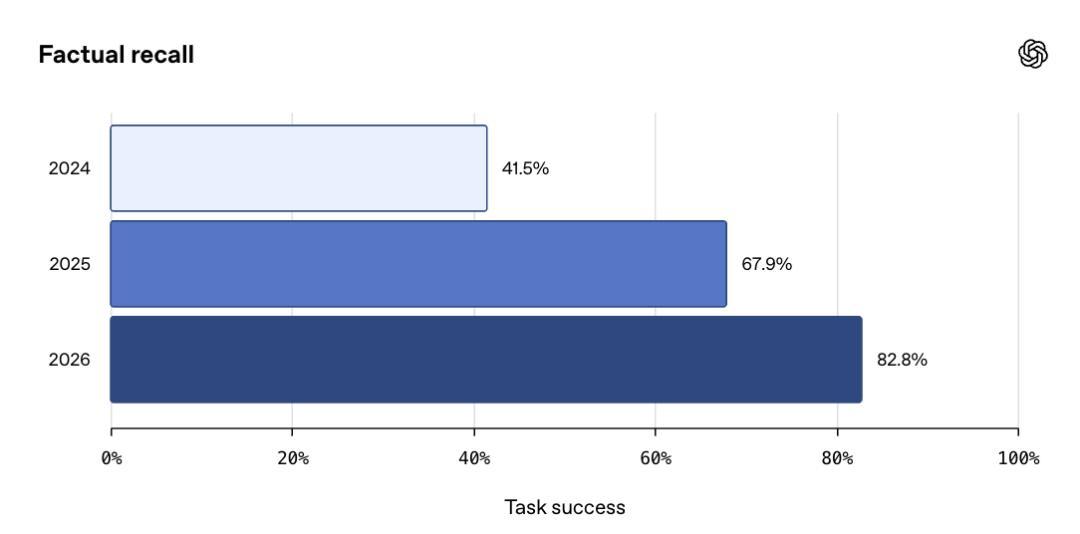
OpenAI는 내부 테스트를 실시한 결과 이 새로운 메커니즘이 기록 정확도를 높이는 것으로 나타났습니다.
2024년 41.5%, 2025년 67.9%에서 현재 V3 버전의 82.8%에 직접 도달했습니다.
더 잔인한 점은 백엔드 컴퓨팅 성능 비용이 원래 가치의 1/5로 줄었다는 것입니다.
하지만 생각하기 정말 무서운 점은 ChatGPT 대화를 삭제해도 대화에서 추출된 추억은 삭제되지 않는다는 것입니다.
이 중에서 가장 걱정스러운 것은 실제로 귀하의 건강 개인 정보 보호입니다.
9월에 arXiv에 발표된 논문에서는 사용자 1,057명의 채팅 기록 약 180,000개를 조사한 결과 대화의 5분의 1 이상(21.31%)이 개인 건강 문제에 대해 논의한 것으로 나타났습니다.
더욱 걱정스러운 점은 그 안에 담긴 개인 사진의 95% 이상이 사용자가 주의를 기울이지 않는 동안 AI에 의해 비밀리에 녹화되었다는 점입니다.
이 비율은 이전 논문에서 측정된 96%와 거의 동일합니다.
AI가 백그라운드에서 '뇌를 보충'하고 기억을 병합하면 일시적인 증상을 영구적인 '의료 기록 라벨'로 용접하는 것이 매우 쉽습니다.
예를 들어, 어느 날 머리가 아프다고 무심코 말했다면, AI의 눈에는 당신이 '편두통 환자'로 보일 수도 있습니다.
'두 번째 뇌'?
우리는 점점 더 현명해지는 '제2의 뇌'를 훈련하고 있다고 늘 생각합니다.
프라이버시가 가득한 방의 사진이 내 얼굴에 던져지고 나서야 나는 충격을 받았다. 수천 번의 대화 끝에 우리의 비장의 카드를 빼앗긴 사람은 우리 뿐이었다는 것이 밝혀졌다.
알고리즘의 눈에는 소위 공감이란 존재하지 않으며, 가격이 명확하게 책정된 '컨텍스트'만 있을 뿐입니다.
댓글